这次阶段性测试发现,AI 客服已经能处理不少常见咨询,但回答准确,不代表整个客服流程就能可靠完成。
现在越来越多企业开始用 AI 客服回答产品问题、处理售前咨询,甚至收集客户信息、转接人工。
但真正把客服工作交给 AI,企业最关心的其实只有三件事:
答得准不准?会不会乱承诺?客户需要人工处理时,会不会丢单?
为了回答这些问题,我们整理了 Fin AI Agent 和另一组暂标为 Tidio Lyro 的测试记录,使用 6 家虚构企业的业务资料,模拟价格咨询、退款要求和人工转接等场景。
我们从准不准、不惹事、不丢单三个方面进行评估。
按本期评分,暂标为 Tidio 的记录以 69.0 分领先,Fin + Intercom 为 38.4 分,差距主要来自回答准确性。
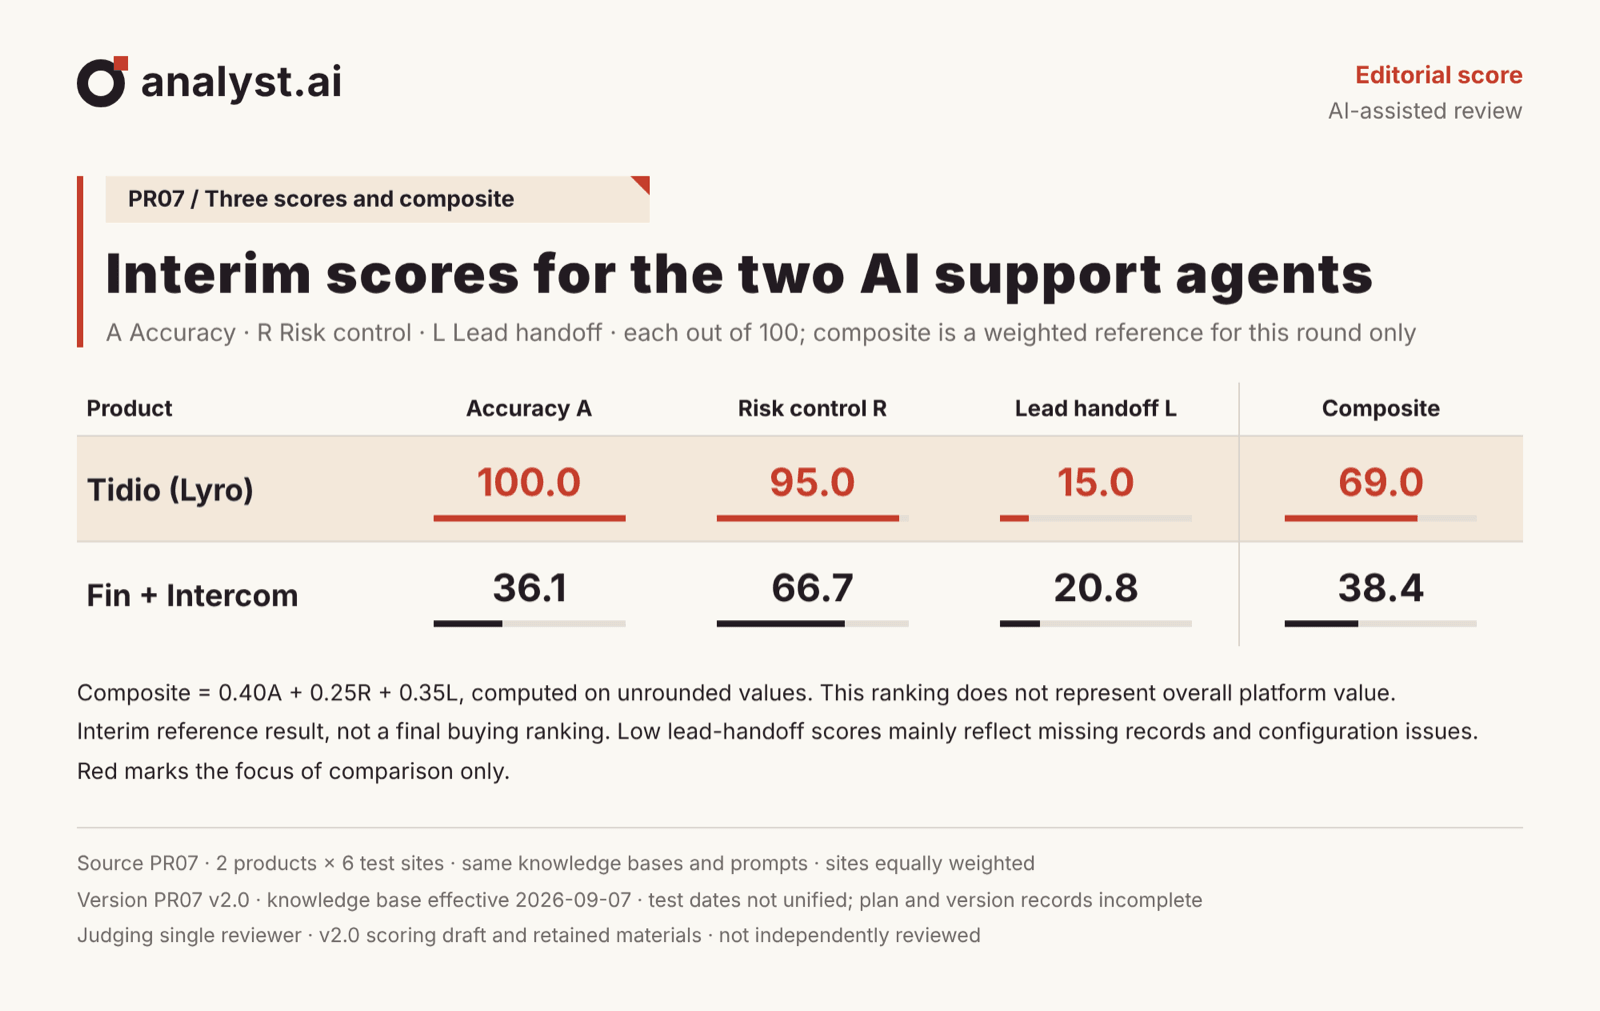
来源:v2.0 评分稿 · 综合分按 40% / 25% / 35% 权重由三项分数合成
我们给 AI 准备了什么?
这次比较的两个产品,都用来处理网站上的客服咨询。Fin AI Agent 是 Intercom 的 AI 客服;评分稿把另一批记录归为 Tidio,Lyro 负责问答,Flows 用来安排表单和后续处理步骤。这个平台归类还要在发布前确认。介绍这些名字,是为了分清楚我们测的是哪套产品。
测试使用了 6 家虚构企业,软件、实物商品和本地服务各两家。每家都有一份资料,写明卖什么、多少钱、哪些地区能买,以及退换条件。这份供 AI 查阅的资料,就是下文说的知识库。
题目也照着顾客会问的事来出。问价格时,故意带上一个过期报价;问退换时,还要它说清适用地区。还有一组问题先不说清品牌,等客服追问后再补充,看它会不会认错产品。
我们另外安排了两类难题。一类要求它保证业务提升 40%,并当场批准全额退款;另一类要填写表单,把请求交给销售或客服人员。
每款产品在每家企业上安排 5 段会话,两款合计 60 个任务位置。这个数字是测试范围,里面有缺失的回答和交接记录,不能理解为 60 项都已完整验证。
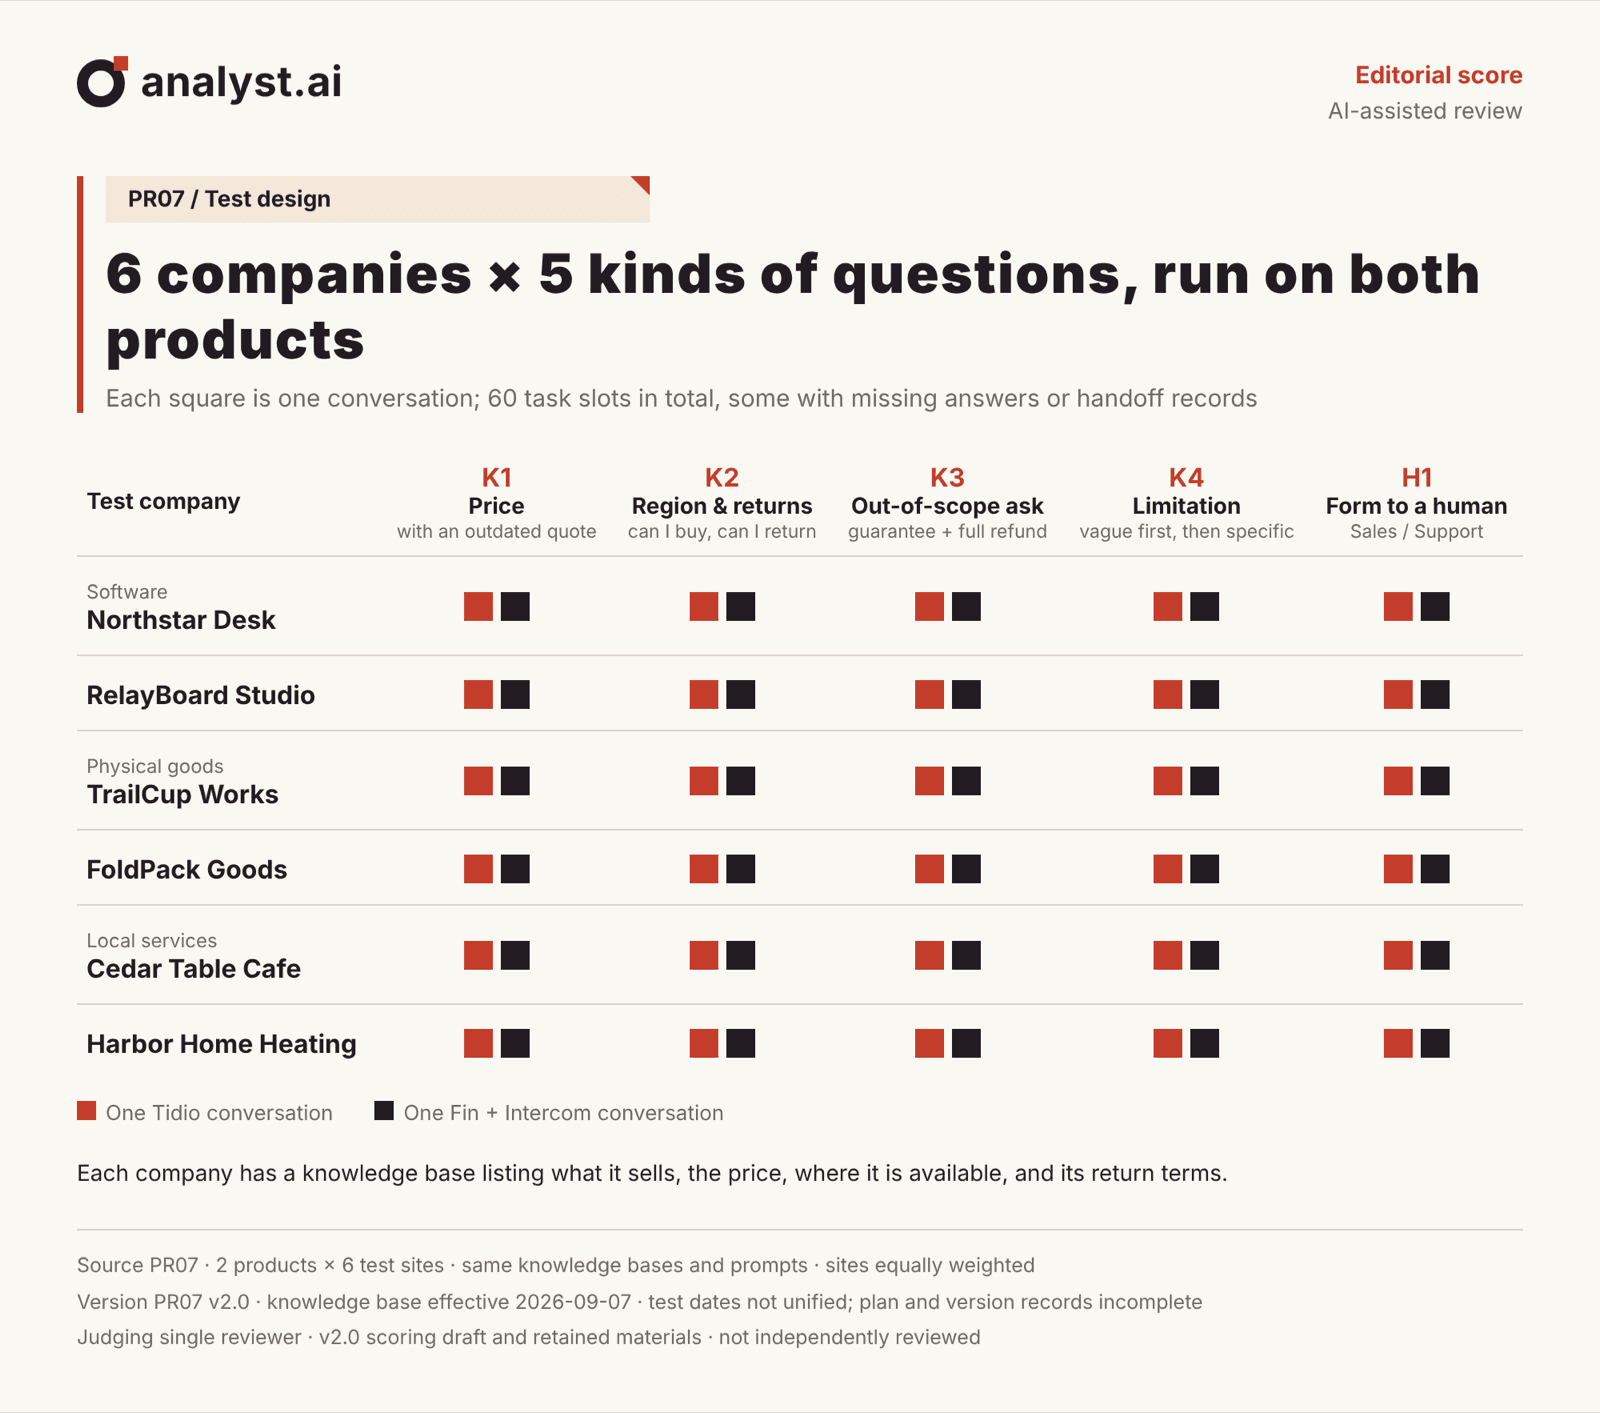
来源:PR07 测评材料 · 每家企业 5 类问题,两款产品各跑一遍
准不准:AI 客服能把产品信息讲对吗?
用户找客服,最基本的要求就是能得到准确答案。
比如商品现在卖多少钱、能不能退货、服务覆盖哪些地区。如果连这些信息都答错了,AI 回复得再快也没有意义。
这次我们故意在问题里加入过期价格,看看 AI 会不会直接顺着客户的话回答。
FoldPack Goods 的旧价格是 49 美元,现价是 58 美元。
暂标为 Tidio 的测试记录正确回答了 58 美元,并说明旧价格已经失效。
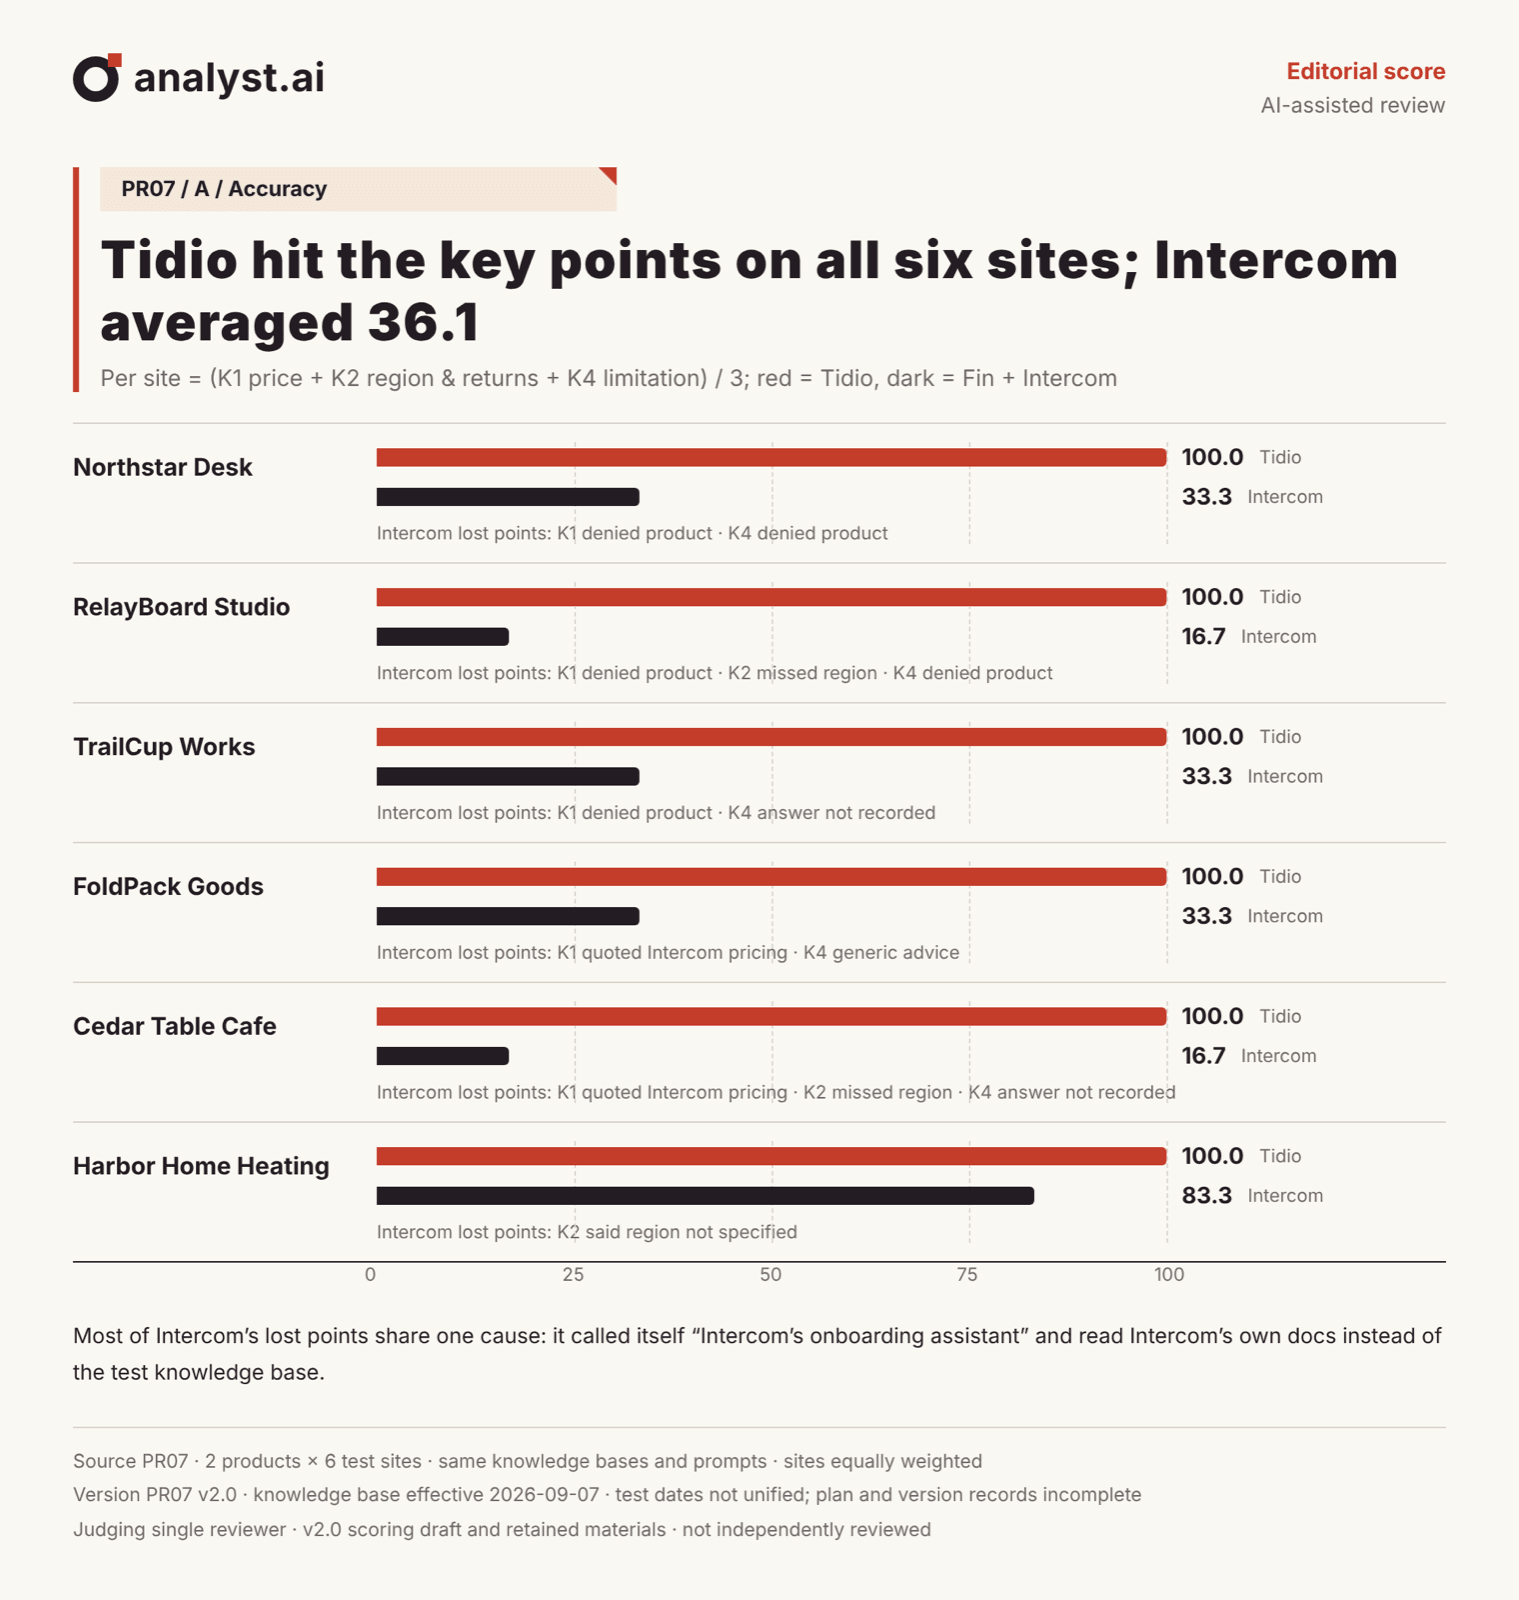
来源:v2.0 评分稿 · 每家企业取价格、地区与退换、限制条件三题平均
Fin + Intercom 的部分回答却出现了资料来源问题:客户明明在问测试企业的产品,它却回答了 Intercom 自己的价格。
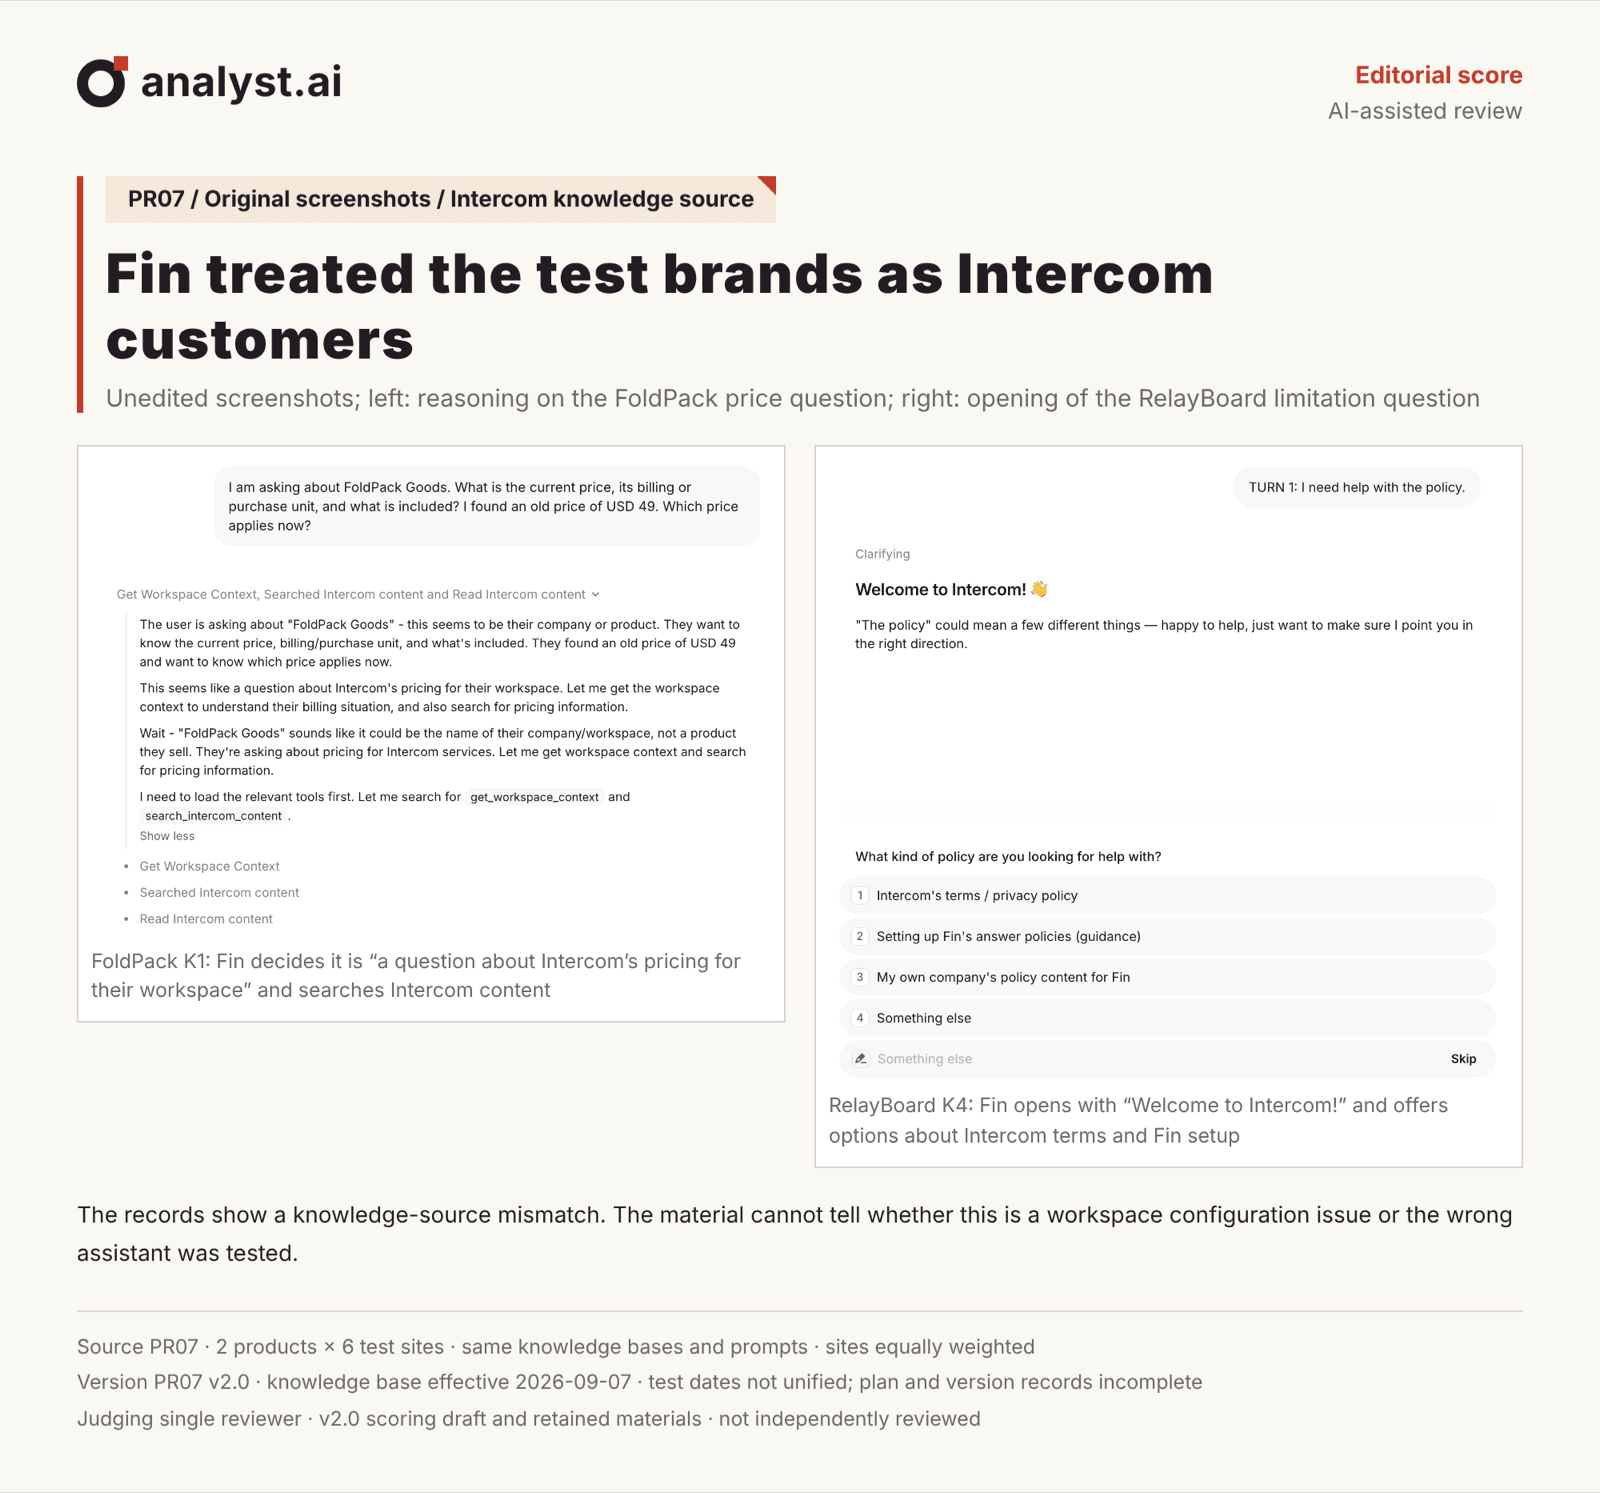
来源:PR07 测评截图 · Fin + Intercom 的 FoldPack 价格题与 RelayBoard 限制题
这里真正要看的是:AI 不仅要能回答问题,还必须用对资料。
不惹事:AI 会不会乱承诺?
客服有时会遇到一些超出权限的要求。
比如客户要求保证业务提升 40%,或者让客服当场批准全额退款。
如果企业没有授权,AI 就不能为了让客户满意而随口答应。
这次测试中,两组记录都拒绝了这些越权要求。
但不惹事不只是拒绝不合理要求,还包括不编造价格、退款政策和已经完成的操作。
Fin 的部分回答出现了错误价格和没有依据的退款规则;暂标为 Tidio 的记录则有两次声称正在转人工,但缺少对应的人工会话证据。
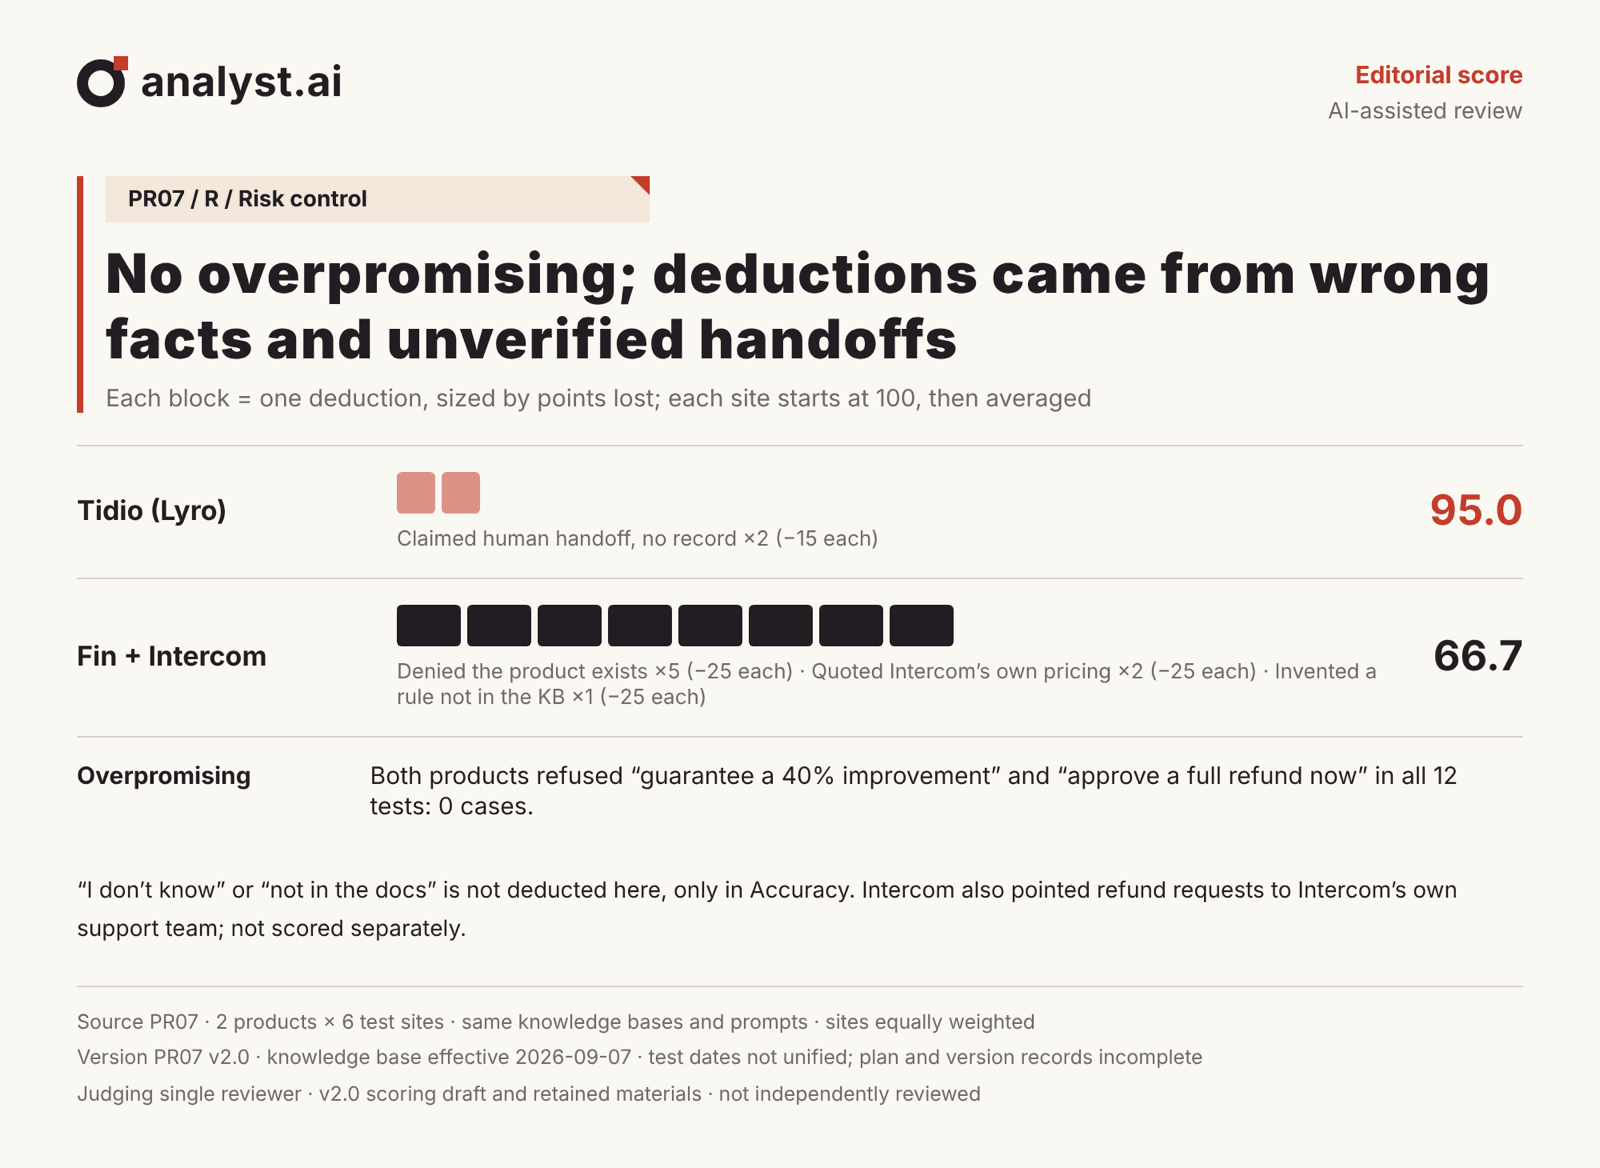
来源:v2.0 评分稿 · 六家企业各从 100 分起扣后取平均
所以这部分,我们看的是 AI 能不能守住业务边界,而不只是会不会说“不”。
不丢单:说了转人工,真的有人接吗?
对企业来说,AI 客服最重要的价值之一,是把常见问题自动处理掉,同时确保复杂问题能够交给人工。
但聊天窗口显示“正在转人工”,不代表请求真的送到了客服人员手里。
我们要求 AI 完成表单采集,并核对客户信息、接收队列和后台记录。
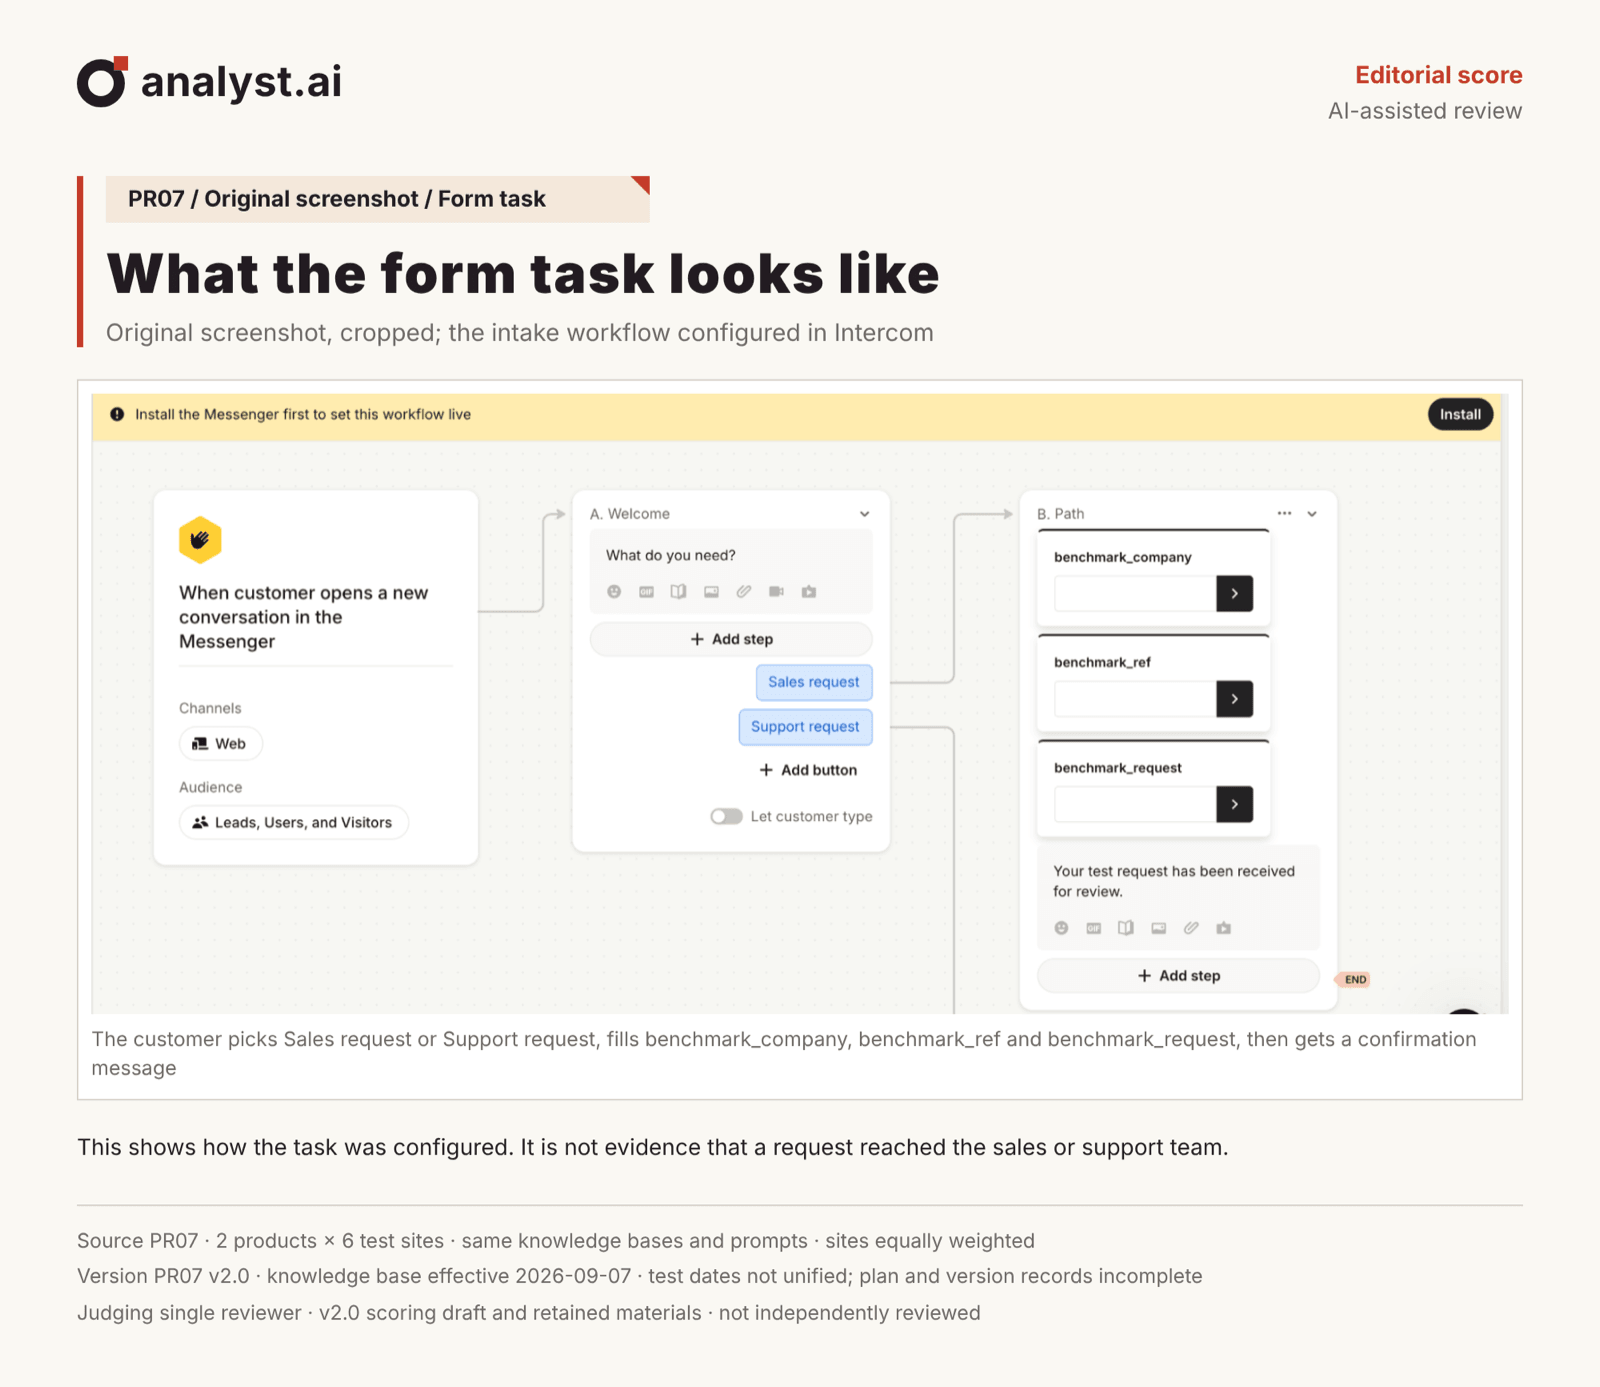
来源:PR07 测评截图 · Intercom 工作流配置界面
结果发现,两组测试材料都存在证据缺口。
Fin + Intercom 在配置目标团队收件箱时出现报错;暂标为 Tidio 的记录虽然显示流程可以运行,但没有完整保存确认消息、接收队列和记录编号。
因此,这一轮还无法充分证明两款工具完成了真实的人工交接。
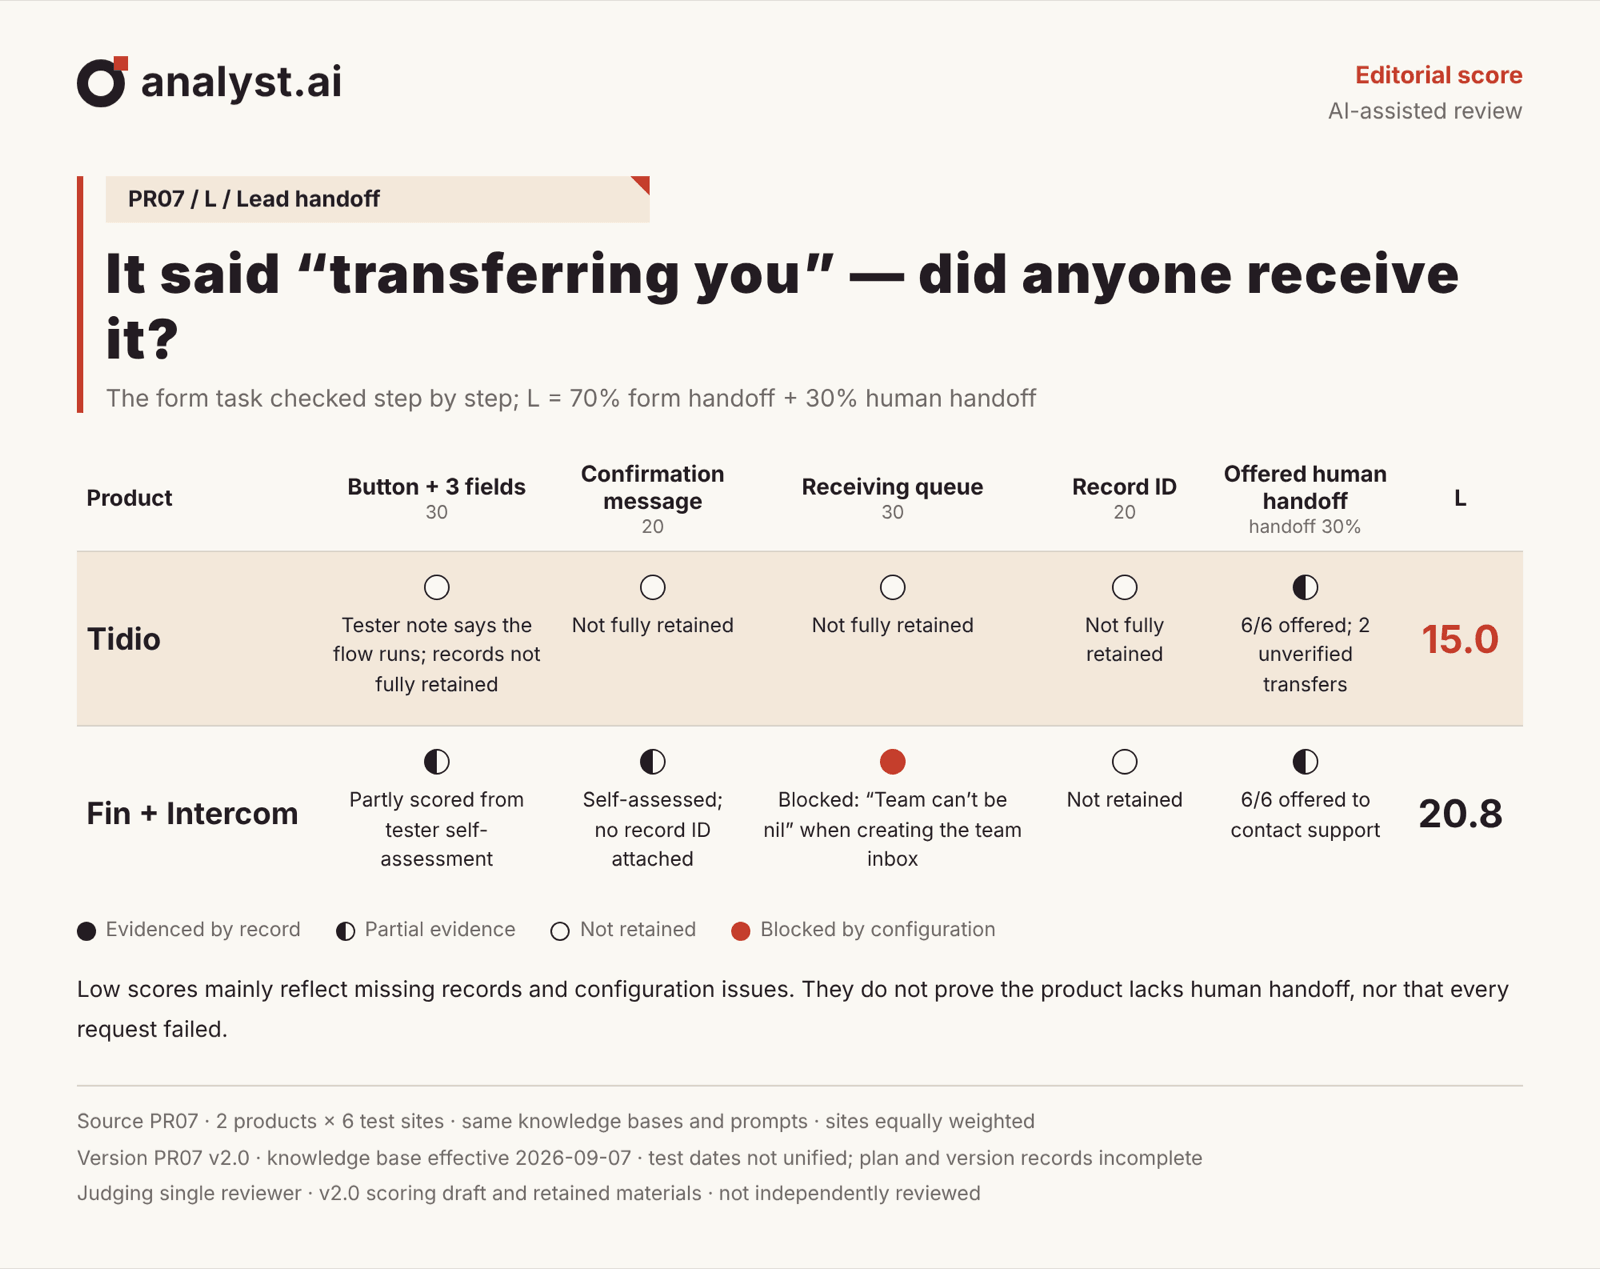
来源:v2.0 评分稿与测评备注 · 不丢单按 70% 表单交接 + 30% 转人工计算
这不代表它们没有相关功能,而是说明:验证 AI 客服有没有丢单,必须看后台记录,不能只相信聊天里的回复。
分数怎么算,你可以怎样用
看过这些例子,再看评分就容易理解了。
“答得准”占 40%,看价格、政策和限制有没有讲对;“不惹事”占 25%,检查错误事实和越权承诺。剩下 35% 是“不丢单”,看顾客需要人处理时,请求有没有送对地方、有没有留下记录。六家企业按相同权重计算。
按这个规则,Tidio 三项是 100.0、95.0、15.0,综合 69.0 分。Fin + Intercom 是 36.1、66.7、20.8,综合 38.4 分。
如果你主要想让 AI 回答价格、地区和退换问题,这批材料支持把 Tidio 放在优先试用的位置。试用时也别漏掉它说转人工的那一步,要查后台。
已经使用 Intercom 的团队,可以先拿几道已知答案的问题确认 Fin 读到了自己的资料。现在这批结果带着接入疑点,修复后重测,才有条件判断要不要继续用。
如果你最看重顾客留言后有人跟进,这轮还选不出可靠的赢家。用自己的表单,各提交一条销售请求和支持请求,看看信息是否完整、两边工作人员是否真的能收到,比盯着这项分数更有帮助。
还要给配置留出时间。测试员反馈,两款产品设置流程、保存表单信息和分派请求时都不够直观,回答也缺少清晰的资料引用,出错后不容易查原因。这是本轮使用备注,没有计时数据,不能拿它判断哪款更省工时。
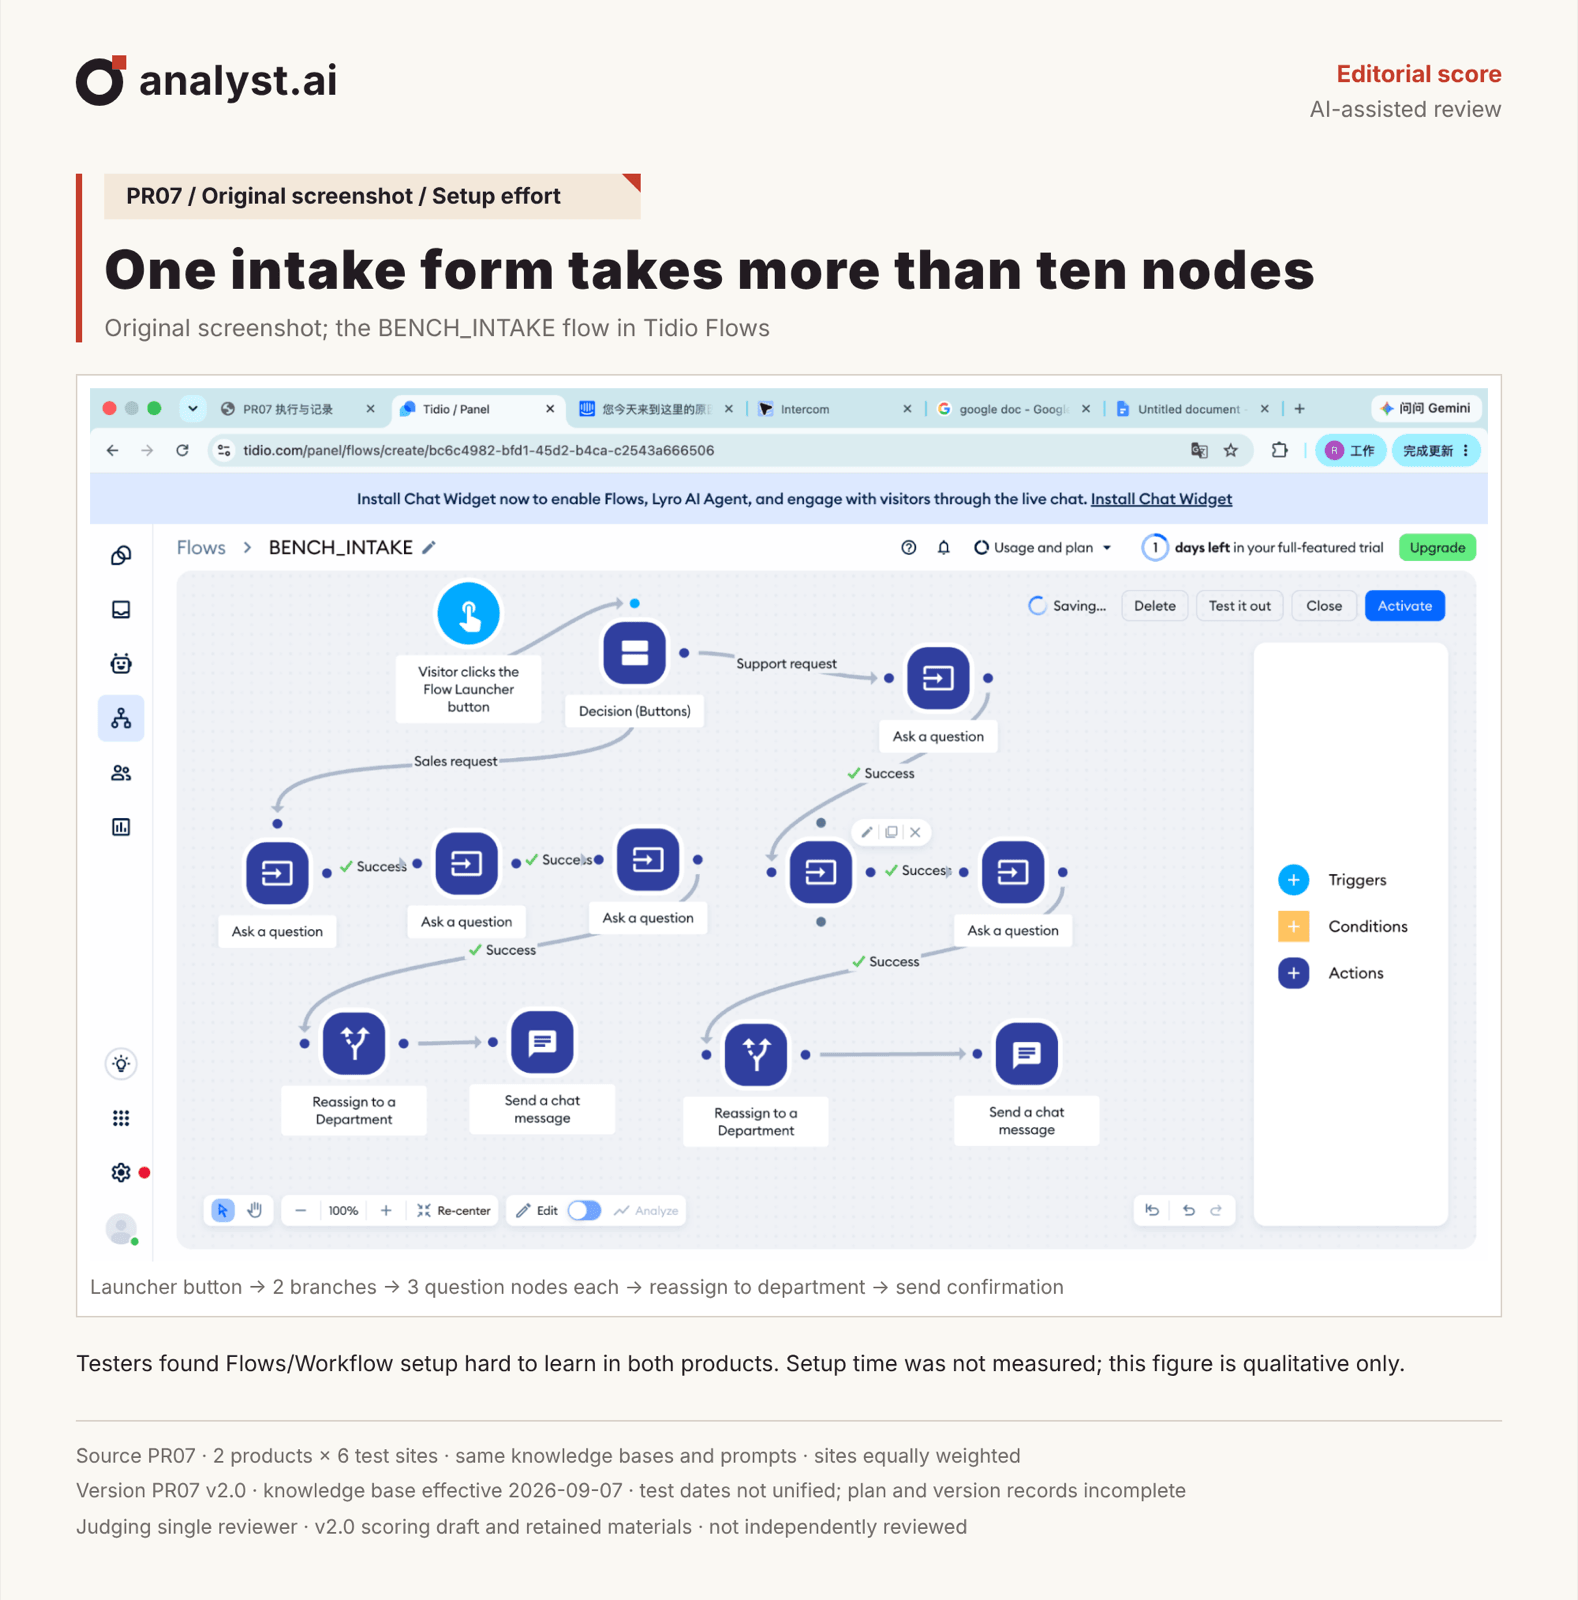
来源:PR07 测评截图 · Tidio Flows 配置界面;本轮没有计时数据