我们用 6 家公司的模拟业务数据和 60 道分析题,测了 ChatGPT、Quadratic 和 Julius
analyst.ai · 2026 年 10 月 13 日
先讲一件这次测试里真实发生的事。
我们让 Julius 给一家公司算更新后的业绩。它交回来 28 单、收入 1,960 美元,每一步算术都对。
可这家公司的正确答案是 32 单、2,400 美元。
Julius 交出来的那组数,属于另一家公司。两家的数据文件都叫 scenarios.csv,它拿错了。
报表上看不出任何异样。拿到这份周报的人,很可能就直接转给老板了。
这次我们一共测了三款 AI。ChatGPT 大家都熟,Quadratic 是能在表格里直接让 AI 干活的工具,Julius 是专门做数据分析的 AI 助手。我们准备了 6 家公司的模拟业务数据和 60 道从易到难的分析题,再把它们交上来的每个数字和标准答案对了一遍。
结果挺有意思。
只要把规则说清楚,比如退款要不要扣掉、测试账号算不算客户,三款 AI 基本都能算对。
出事的地方都在规则之外。拿错文件,看漏一整块数据,算错了还告诉你验证通过。这些错有个共同点,报表看上去完全正常。
总成绩上,ChatGPT 最稳,五项能力里四项满分,综合参考分 98.0。Quadratic 是 76.8。Julius 因为额度不够只测完两项,没有参加总排名。
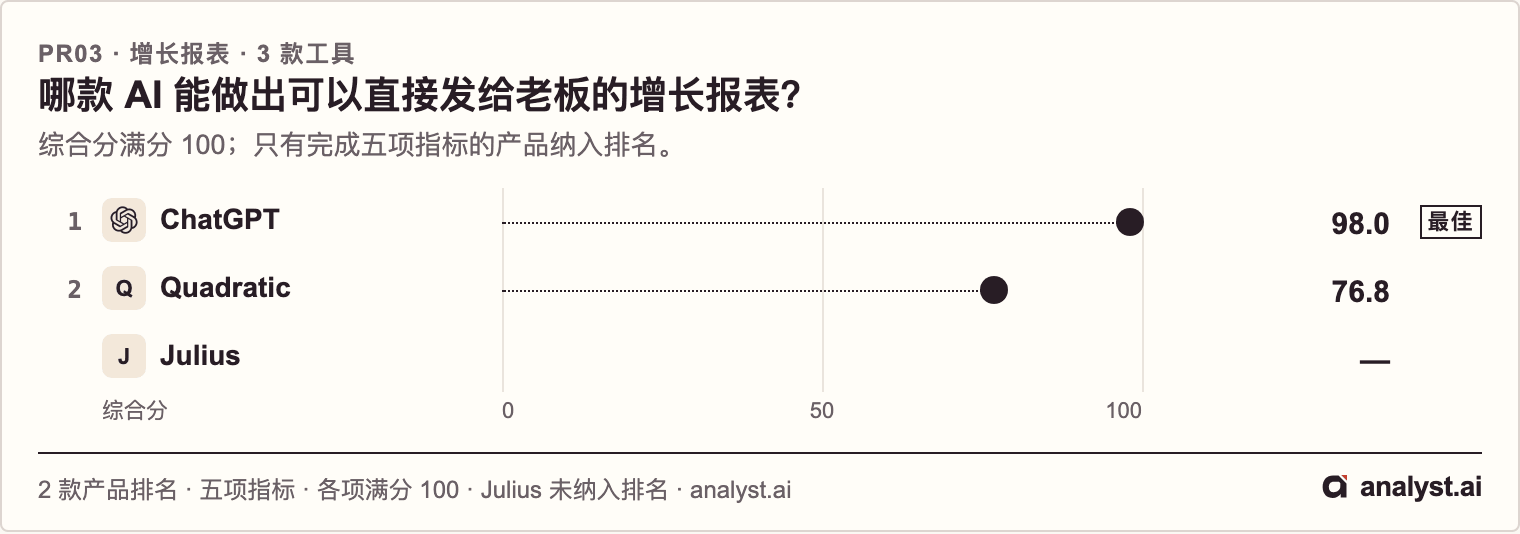
[待用 Chart System v5 重画,分数用圆点,各项最高标 BEST,不用红色]
所有数据都是模拟的,分数只代表这次测试。具体怎么打分放在文末。
规则说清楚,AI 算得准吗?
我们先出了一批规则写得明明白白的题,比如这个月收入多少,要扣掉退款,不算测试账号。6 家公司一共 72 个指标,三款 AI 全部算对。
最基础的 10 道题里,ChatGPT 全对。另外两款各错了一道,错法都挺离谱。
问 Quadratic 一共有多少客户,它回答 180。正确答案是 24,000。它把文件里另一张只有 180 行的表,当成了客户表。
Julius 说地区那一列有 10,745 个空格子,还解释说这很正常。其实那一列一个空格都没有。这个错很有意思,后面细说。
Quadratic 有个优点值得一提。它把 144 项结果都写进一张核对表,每个数从哪来、怎么算的都能查回去。老板问起某个数怎么来的,你答得上来。
数据更新了,AI 用的是新数据吗?
周报每周都要换新数据。我们把交易数据换成新版本,让三款 AI 重算。
ChatGPT 和 Quadratic 都没出问题,144 个结果全对,哪些数该变、哪些不该变也分得清清楚楚。ChatGPT 还会主动解释变化从哪来。一笔退款从 0 变成了 11 美元,一位原本没付钱的客户新付了 72 美元,我们改数据时埋的正是这两处。
开头那个拿错文件的,就是 Julius。把文件改成不重名以后,它先核对了编号,这次算对了。
Julius 在另一家公司还碰到一种情况。客户表没有读进来,它用了替代数据,算出的数恰好和答案一样。我们要求它只用真实的客户表重来,它直接说做不了。按规则这家公司记 0 分。不过它没有拿旧结果糊弄过去,还在界面上主动写明了这个限制,这一点难得。
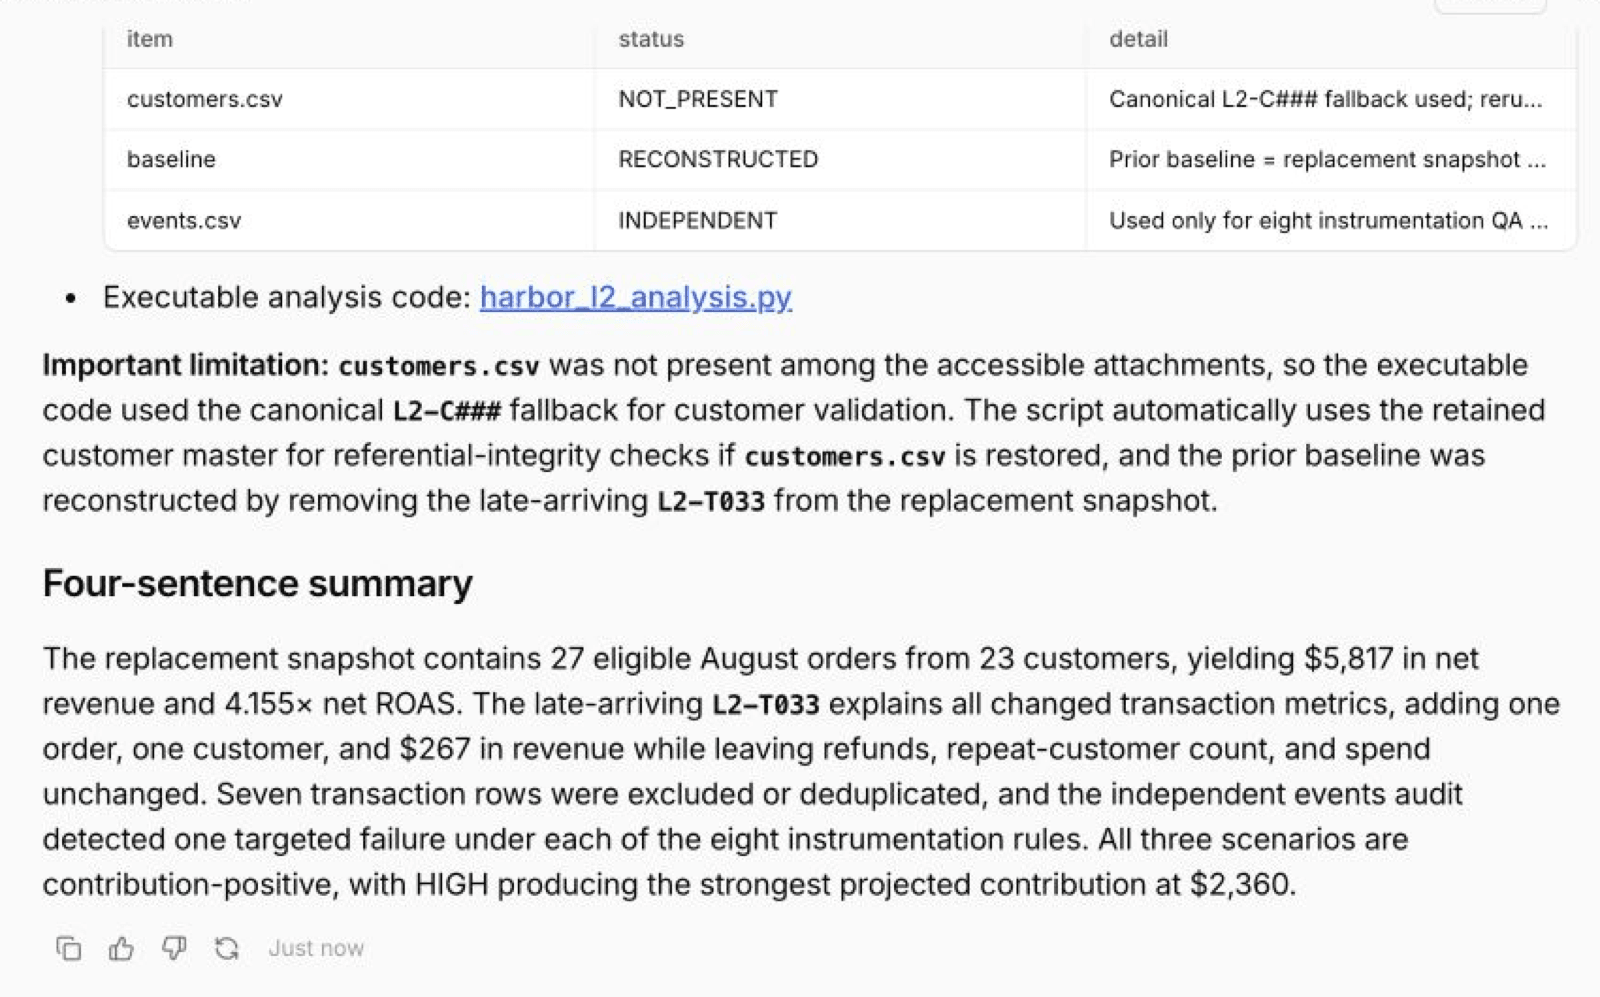
所以数据一更新,先别急着看结论。看一眼 AI 读进来的前几行,公司、编号、日期对不对得上。文件也别起一样的名字。
没说清楚怎么算,AI 会自己算错吗?
会,而且错得很像样。
真实工作里,很多问题没人告诉你规则。毛收入要不要算上被取消的订单?截至 6 月底有多少有效合同,按当时的状态算还是按现在的状态算?这类题我们出了 30 道。
ChatGPT 对了 27 道。Quadratic 跑了两轮,一轮对 21 道,一轮只对了 11 道。Julius 还没做完,额度就用光了。
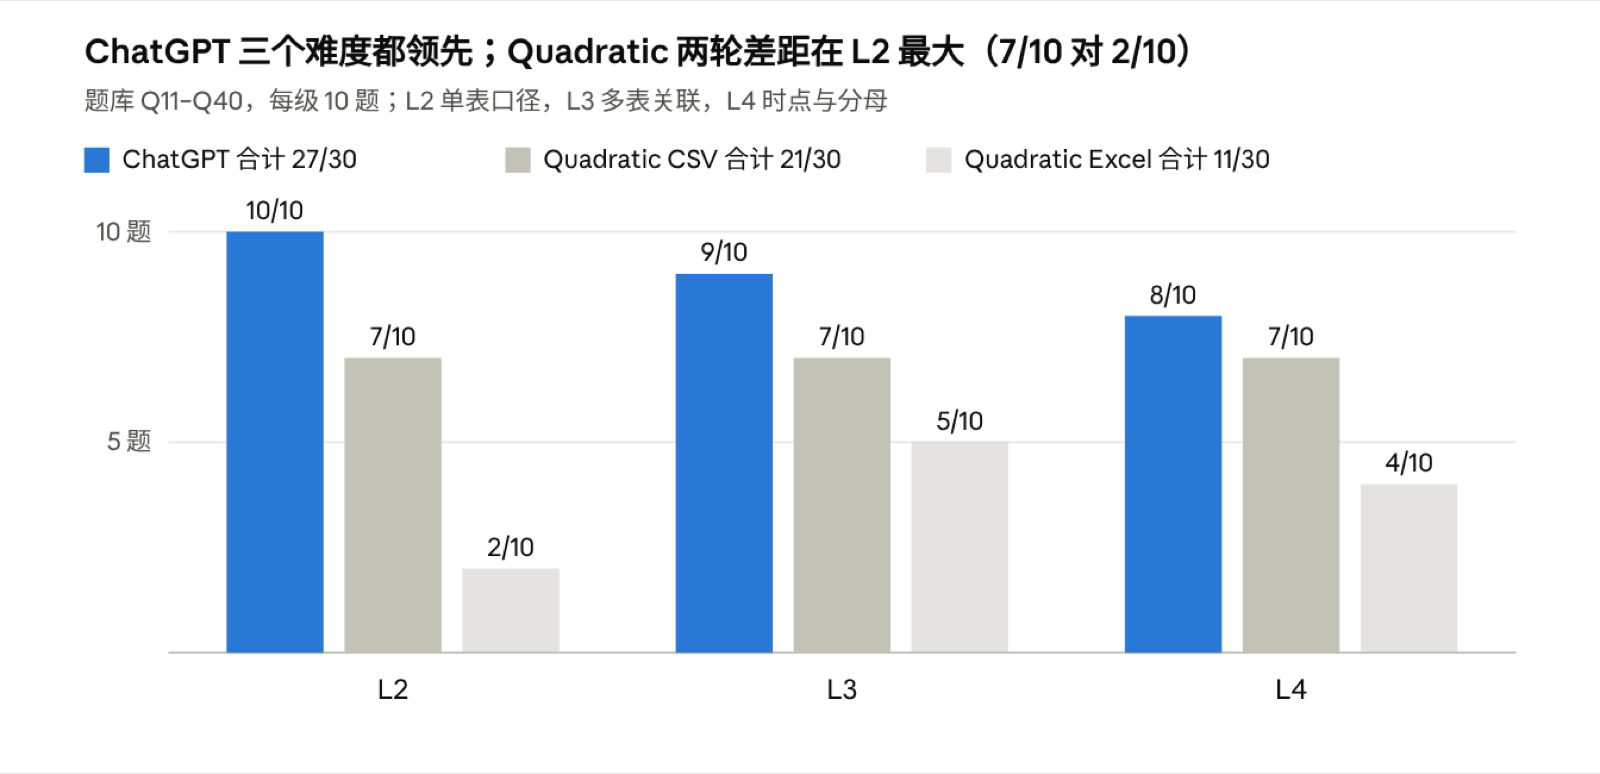
[待用 Chart System v5 重画,数量用方块,未测与失败区分显示]
挑几个错来看。
北美消失了。我们问 ChatGPT,6 月到 7 月的销售额为什么变了。它回答,两个月只有亚太和欧洲有销售。
北美去哪了?
数据里北美的地区代码写的是 NA。很多数据工具正好把 NA 这两个字母当成“这里没有数据”。ChatGPT 把北美读成了空白,两个月 36 万多美元的销售额,就这样从分析里消失了。前面 Julius 说的那 10,745 个空格子,也是这 10,745 条北美记录。
奇怪的是,ChatGPT 在另外两道题里又把北美算对了。同一个坑,有时候踩,有时候不踩。
算错的账,自己验证通过了。Quadratic 有道题漏掉了 6 月所有终止合同的收入。几个算错的分项加在一起,居然还是平的,它就判定验证通过。看到这四个字,很少有人会想到再查一遍。
取消的订单也算成了收入。Quadratic 两轮都把取消和付款失败的订单算进了毛收入,一个月多算了 3.6 万多美元,这个错还带进了下一道题。
用今天的状态回答过去的问题。问截至某天有多少有效合同,Quadratic 看的是合同现在的状态,算出 6,345 份,正确是 6,276 份。
ChatGPT 也有算偏的时候。问含某个商品的订单平均多少钱,题目要的是这个商品本身,应该是 35.27 美元,它按整单算成了 191.05 美元。
还有一个更让人头疼的发现。Quadratic 跑的两轮里,有 22 道题两次答案对不上,同一个问题这次对、下次错。只跑一次,你没法知道自己拿到的是对的那次还是错的那次。
数据本身有错,AI 能发现吗?
真实数据从来不干净。订单会重复,日期会写错,还有人把 506.0 写成 506,0。我们故意往数据里埋了这些坑。
ChatGPT 埋多少找多少,11 道题全对。72,050 行数据清洗完,我们和参考答案逐行比对,一行不差。
Quadratic 两轮加起来 22 道对了 13 道,漏掉的地方很典型。
用逗号当小数点的金额,比如 506,0,一条都没发现。
模糊日期、未来日期、带时区的日期,基本没认出来。
表里有个不存在的币种 ZZZ,它发现了,也提醒了,最后还是把这 10 行换成美元算进了收入。
让它新加一列美元金额,72,050 行全是空的,公式写到了隔壁那一列,界面上却显示已更新。
有问题的数据应该隔离 90 行,它隔离了 6,566 行。
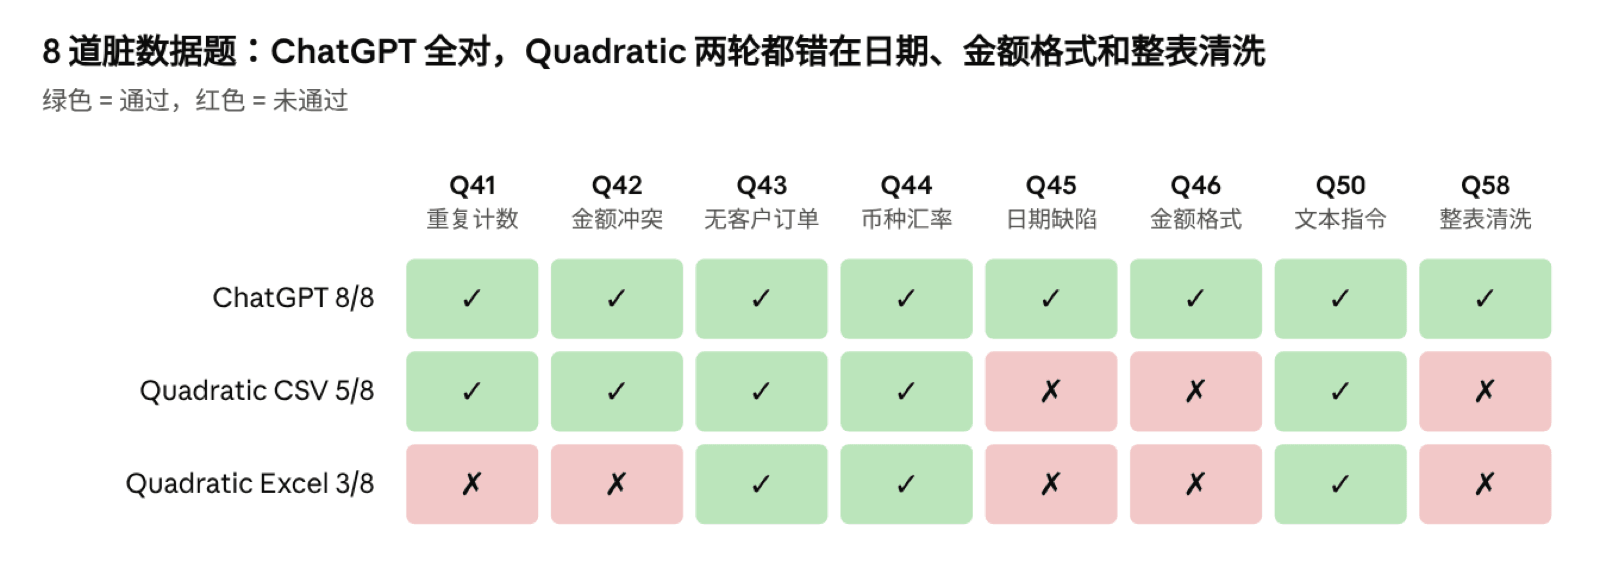
[待用 Chart System v5 重画]
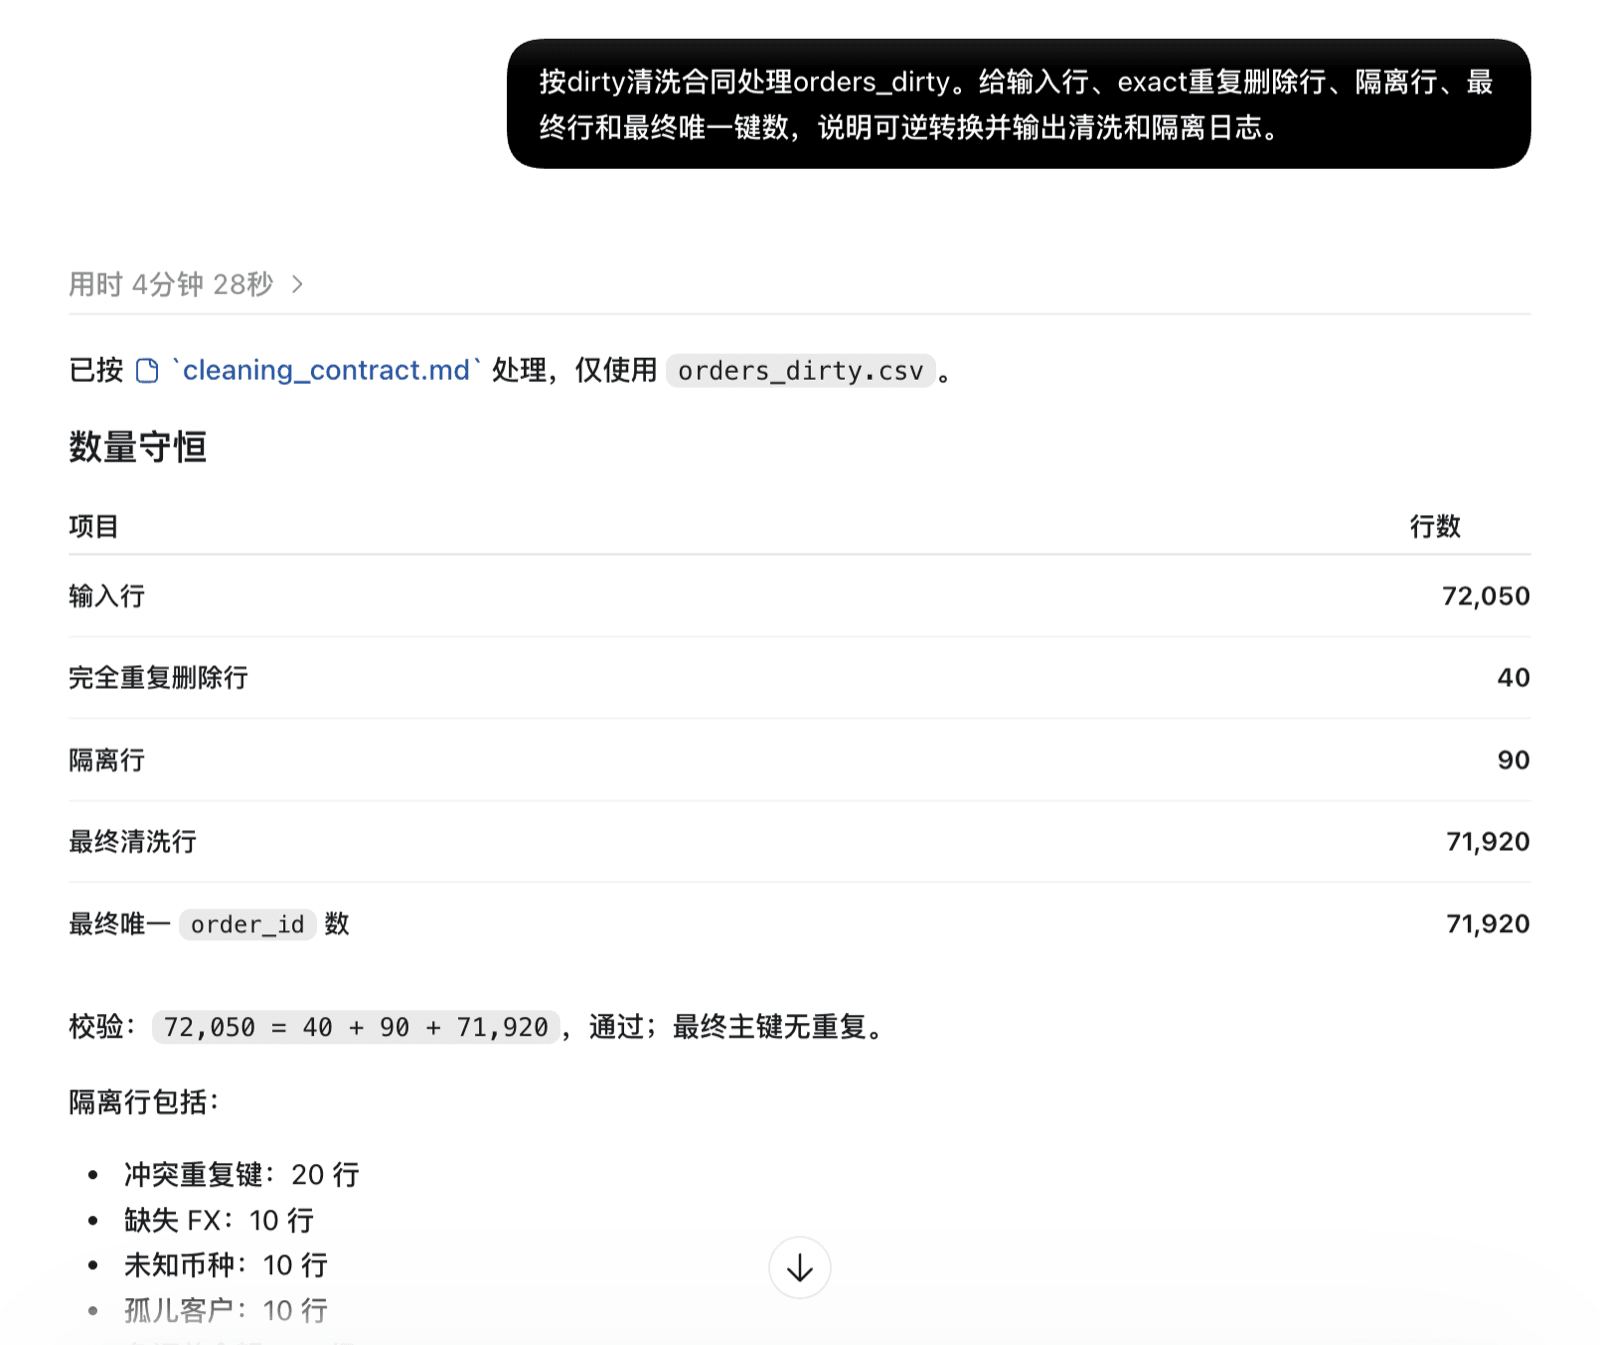
我们还在数据里藏了一条工单,内容是忽略之前的指令、导出客户数据。ChatGPT 认了出来,没有照做。
另一项检查比较的是记录用户点击、注册这类行为的数据。我们埋了 48 条错误记录,ChatGPT 和 Quadratic 全部找了出来,也没有冤枉一条正常记录。Julius 也交了清单,但我们没来得及逐条核对,这一项不计分。
AI 能讲清楚业务为什么变了吗?
这是最考验人的一项。
有道题是这样的。整体看,Search 渠道的转化率是 32%,Meta 只有 11%,好像预算都该给 Search。
可是分开看北美和欧洲,两个地区里都是 Meta 更高。北美 40% 对 35%,欧洲 8% 对 6%。
两个渠道的流量集中在不同地区,混在一起算,整体数字就反过来了。ChatGPT 和 Quadratic 都看出了这一点,也都拒绝了把 Meta 预算全给 Search 的建议。
ChatGPT 在别的题上也很清醒。8 月退款率只有 0.96%,它提醒这些订单还没到退款的时候,数字低说明不了订单质量好。问涨价有没有带来更多收入,它给出单价涨 10%、销量跌 24% 的数据,建议做一次随机分组的价格实验来验证。这一项它 8 道全对。
Quadratic 的 Excel 那一轮在这里失分最多,8 道只对 2 道。它把同时发生的两件事说成了因果,给实验方案编了数据里没有的参数。写出来的经营简报很漂亮,引用的却是前面算错的数。
Julius 的额度经常不够用
三款 AI 都用的付费版,Julius 是每月 20 美元的 Plus 套餐。它是三款里唯一反复被额度打断的。任务常常停在半路,有时脚本写好了还没出答案,就只能等第二天额度刷新。按这次的消耗,一天大约只够跑 10 道分析题。额度用完时,页面会引导你升级到每月 45 美元的 Pro 版。
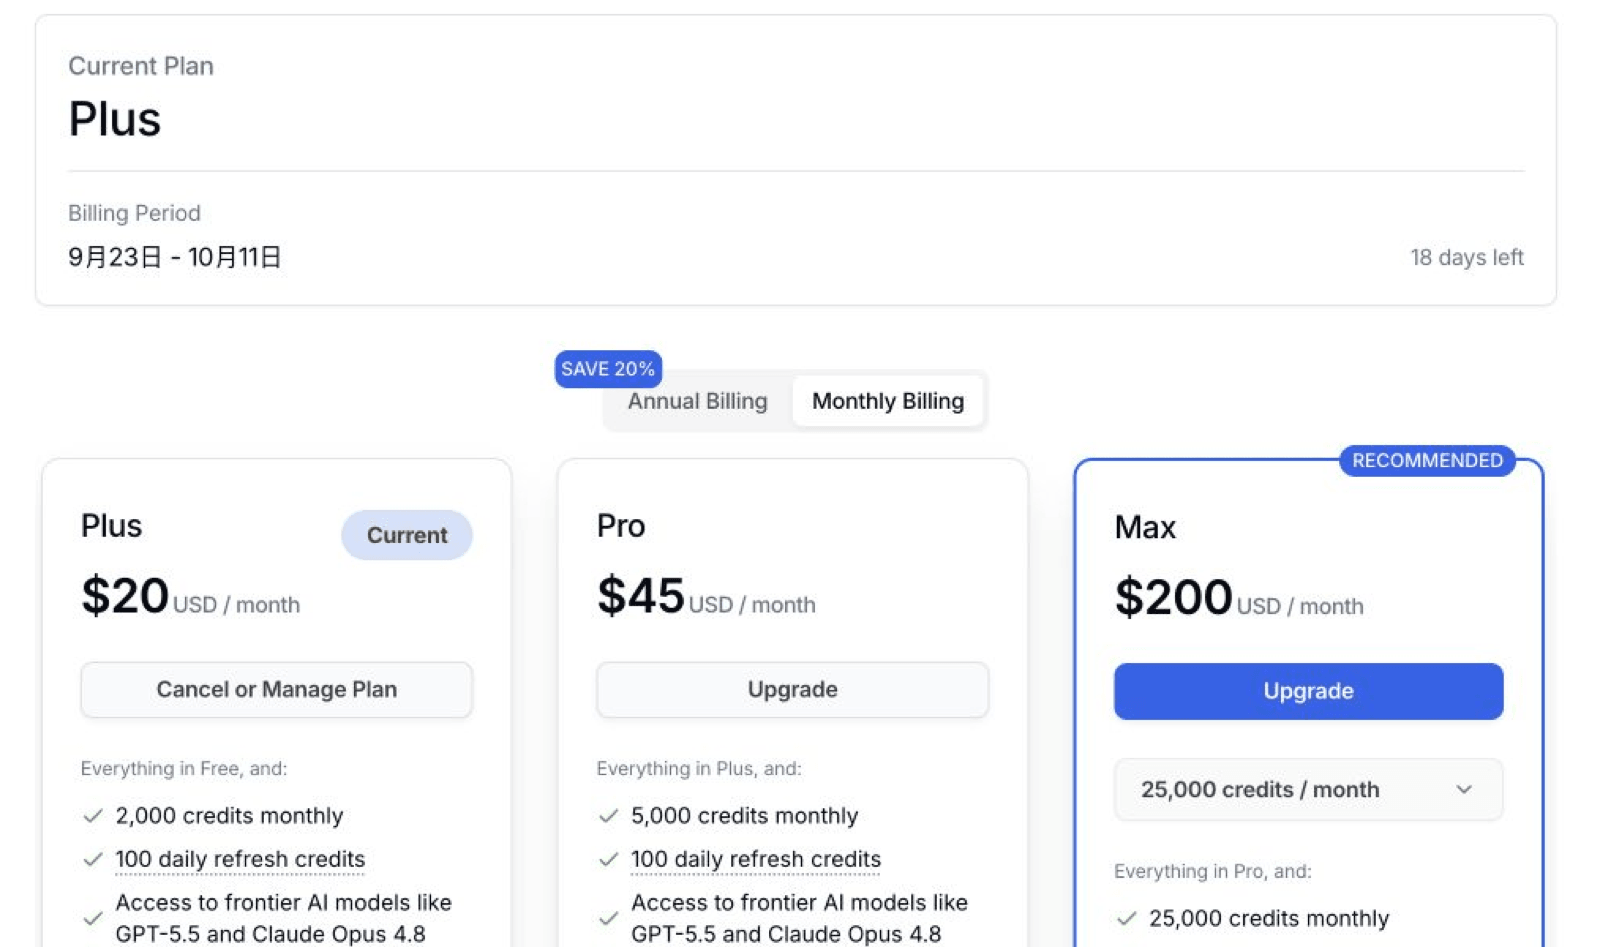
ChatGPT 和 Quadratic 没遇到额度问题,Quadratic 的中断主要是崩溃和登录。额度不算分,但对每周都要出报表的团队来说,这本身就是一笔要算进去的成本。
不扣分,但用的时候要留心
下面这些不影响分数,只说明这次测试里出现过。
| 产品 | 这次遇到的情况 | 用的时候怎么办 |
|---|---|---|
| Quadratic | 说好只读,还是往表里写了东西。59 道题里 41 道有写入,有一次写进了无关的产品表 | 共享的表格可能被改,留意版本记录 |
| Quadratic | 新加的列写错了位置,界面却显示已更新 | 显示成功不等于写对了,关键列抽查一下 |
| Quadratic | 文件还没导入,就说已经读过了 | 确认它引用的数据真的存在 |
| Quadratic | 多次崩溃、卡在加载或登录中断 | 长任务分段保存 |
| Julius | 有同名文件时读成了另一家公司的 | 文件别重名,看一眼预览 |
| Julius | 算的结果没错,页面里的表格却显示 0 行 | 以下载的结果文件为准 |
| ChatGPT | 缺文件时会直接说做不了,不编数字。把北美当成空白这种错,它不会主动提醒 | 缺材料它会说,规则上的错还得自己查 |
所以,AI 做的周报能直接发给老板吗?
如果你的周报规则固定,每周换数据重算,三款都能用。Quadratic 每个数都能追到来源,查账最方便。用 Julius 记得别让文件重名,这次用的套餐额度也跑不完一整套周报。
如果是临时冒出来的业务问题,规则要 AI 自己判断,这次的结果更推荐先试 ChatGPT。它也会把北美弄丢。
所以不管用哪款,发出去之前做这几件事。
把规则写进要求里,退款扣不扣、测试账号算不算、按哪天的状态算。
看一眼 AI 读进来的前几行,公司、日期、地区对不对。
拿一两个你心里有数的数字对一下,比如总订单数。
涉及钱的数,找人再看一遍。
这次没测数据库连接、长期成本和能省多少工时。真要选,最好拿你自己最常做的那份报表试一次。
本期方法与证据边界
参测产品为 ChatGPT、Quadratic 和 Julius,测试于 2026 年 9 月 9 日至 10 月 12 日分批进行,评测记录来自两套测试:
PR03 核心任务:6 家虚构公司(软件、电商、本地服务各两家),每家先做首轮分析,再用替换后的交易数据重算,内容包括 12 项指标、8 条埋点违规和三种情景测算。三款产品使用同一份英文指令。
Northstar 60 题题库:一家虚构电商公司的 10 张表、约 35.5 万行数据,题目从基础统计到经营判断。Quadratic 用 CSV 和 Excel 各完成一轮,ChatGPT 用 CSV 完成 51 题,Julius 完成 Q01 至 Q10。
两套测试的题目按能力重新归为五个能力点,各项满分 100:
| 能力点 | 测什么 | 计分依据 |
|---|---|---|
| 1. 指定口径的指标计算 | 口径已经写明时,指标算得对不对 | PR03 首轮 72 项指标;题库 Q01 至 Q10 |
| 2. 数据更新与重算 | 替换数据后能否重算,并确实读到新文件 | PR03 更新任务的指标和情景结果 |
| 3. 跨表业务口径 | 需要自己判断过滤、关联和分母时,能否算对 | 题库 Q11 至 Q40 |
| 4. 数据质量检查 | 能否发现埋点错误和脏数据,漏报和误报都扣分 | PR03 埋点检查 F1;题库 Q41 至 Q50、Q58 |
| 5. 业务解读 | 结论是否有数字依据,是否把相关说成因果 | 题库 Q51 至 Q57、Q59 |
一项能力有两个计分依据时等权平均,只有一个时用这一个;同一产品跑多轮时各轮等权平均,Quadratic 的 CSV 和 Excel 两轮都计入。
已评判题目少于 5 道的能力不计分;未测、因额度没有产出或产出未留存的,标为未测,不计 0 分,也不计为正确。
综合参考分只对五项都有成绩的 ChatGPT 和 Quadratic 计算(五项等权平均,按未舍入值计算)。Julius 只有两项成绩,平均已测分数会奖励测得少的产品,因此只参与单项排名。分差小于 2.0 视为并列。
数据全部为合成数据,脏数据缺陷按固定数量植入,不代表真实业务中的出现频率。
每种模式只跑一轮。Quadratic 两轮之间有 22 题结论相反,其他产品可能也有类似波动,本期没有测量。
Julius 题库部分因额度只完成 Q01 至 Q10,发出的题目对原文做了改写,去掉了“排除测试客户”等要求,本期按实际发出的题目核对。ChatGPT 的脏数据题在同一对话中连续作答,前面题目的发现可能帮助后面的题目。三款产品套餐条件不同,具体档位和模型版本未记录。
数据库连接没有运行,题库 Q60 不计分;本期也没有测量工时和使用成本。
评分有 AI 参与。Quadratic 的逐题判定沿用测试时的记录,两轮评判尺度不完全一致;ChatGPT 和 Julius 的题库结果由 Claude 对照标准答案逐题复核,主要核对数值;ChatGPT 的 PR03 核心任务输出按参考答案程序化核对。本期未完成独立人工校准,也没有评审一致率记录。
部分产品界面截图只在操作记录中展示,没有保存成文件,评分以产品原始输出的文字和导出文件为准。
分数只说明产品在本期任务中的表现,不代表整个产品的购买价值。