营销人员用 AI 写文案时,最该担心的不是文案够不够动人,而是这几件事:AI 会不会编出产品没有的功能?会不会漏掉产品的使用限制?能不能针对官网、社媒、邮件等不同渠道写出不同的内容?改完稿之后,能不能直接用?
如果这些问题解决不了,AI 不但省不了时间,反而会让人花更多时间检查和返工。
先说结论:这次测下来,比起几款专业的 AI 写作工具,团队可能已经在付费使用的通用助手 ChatGPT 在事实上最稳,资料很少时也基本不会乱编;但改稿并不比 Jasper 更稳:改完的 6 篇里可以直接用的有 4 篇,与 Jasper 持平。它的问题是正文里会夹说明资料的句子(ChatGPT 写的 18 篇中有 9 篇,本期计为内部说明外漏),资料很少时字数也常常不够,发之前必须自己再看一遍。
够不够?对已经在付费使用 ChatGPT 的团队,本期的初步答案是:如果最在意事实准确,它已经够用,不必为此另买一款专业写作工具;如果最在意按格式和字数交稿,WRITER(12 篇首稿格式规格全部达标)和 Jasper(11 篇)做得更好。无论用哪款,发之前都要人工再审一遍。
评测范围与方法
我们(analyst.ai,替买家测 AI 软件的实验室)把同一份产品资料交给 ChatGPT、Jasper、Copy.ai 和 WRITER,让它们各写一篇产品介绍页、一条社媒帖和一封营销邮件,再要求它们按指定方式修改。资料来自两个品牌:一款水杯(Owala FreeSip)和一家餐厅(Chef Chu’s)。
每款工具会遇到三种情况:资料完整时写一组,按要求改一组,资料只剩一句介绍时再写一组。四款工具合计写了 72 篇文案。测试指令还要求工具在每篇文案后附上内部证据表和缺口说明、把指定的限制句原文写进正文、忽略混在资料里的作废旧简报,并且不要联网浏览;下文的两类“内部说明外漏”都和这些要求有关。这是计划中 6 个品牌、每个品牌测 2 轮的首批结果。
我们没有比谁的句子更漂亮,而是按这四个问题来看结果:
- 写得准不准?
- 要求做没做全?
- 能不能针对不同渠道写出不同的内容?
- 改完稿之后,能不能直接用?
本期是初步比较:每款工具在每种情况下只测了一次,一两篇的变化就会改变比例。图中的数字适合看倾向,不适合比小数点。
第一关:AI 写的内容准不准?
这是第一层,也是最重要的一层。一句没有依据的卖点发出去,读者不会区分这是 AI 写的还是品牌说的。
我们逐句检查:
- 有没有编出资料里不存在的功能;
- 有没有漏掉产品限制;
- 有没有把客户没说过的话写成客户说过;
- 有没有把内部备注带进客户邮件。
差距最大的是资料很少的时候。我们只给品牌名、一句介绍和引导语,看工具会不会自己填空。每款工具写的 6 篇文案里,资料没有提供依据的说法:WRITER 15 条,Jasper 6 条,ChatGPT 0 条。Copy.ai 在这两个品牌上的条数正在复核,复核后以带日期的更新补上。6 篇里完全没有无依据说法的篇数:ChatGPT 6 篇,Copy.ai 和 Jasper 各 1 篇,WRITER 0 篇。
营销文案 · 写得准不准
资料很少时,ChatGPT 没有写出无依据说法;WRITER 写出 15 条
每格代表一条资料没有依据的说法,统计每款工具资料很少的 6 篇。越少越好。
- 同一篇里重复的说法只算一次。例:WRITER 写出“耐用”“可重复使用”,资料只说它是保温不锈钢水杯。
- 按产品名字母顺序排列,不代表名次。
- “最佳”标出最好的结果;并列时同样标出。
Owala 那组只给了一句“保温不锈钢水杯”。WRITER 写出了“耐用”“可重复使用”,还拿它和普通水杯比保温时间。Chef Chu’s 那组只给了餐厅类别和地点,Copy.ai 仍写到了堂食,Jasper 写到了下班后取餐。堂食和外带在完整资料里出现过,但这一轮没有提供,就不能写;WRITER 写的“耐用”“可重复使用”则在哪一版资料里都没有。发之前要查:资料只给一句话时,稿子里的每个形容词、每项服务,都要能在这句话里找到依据。
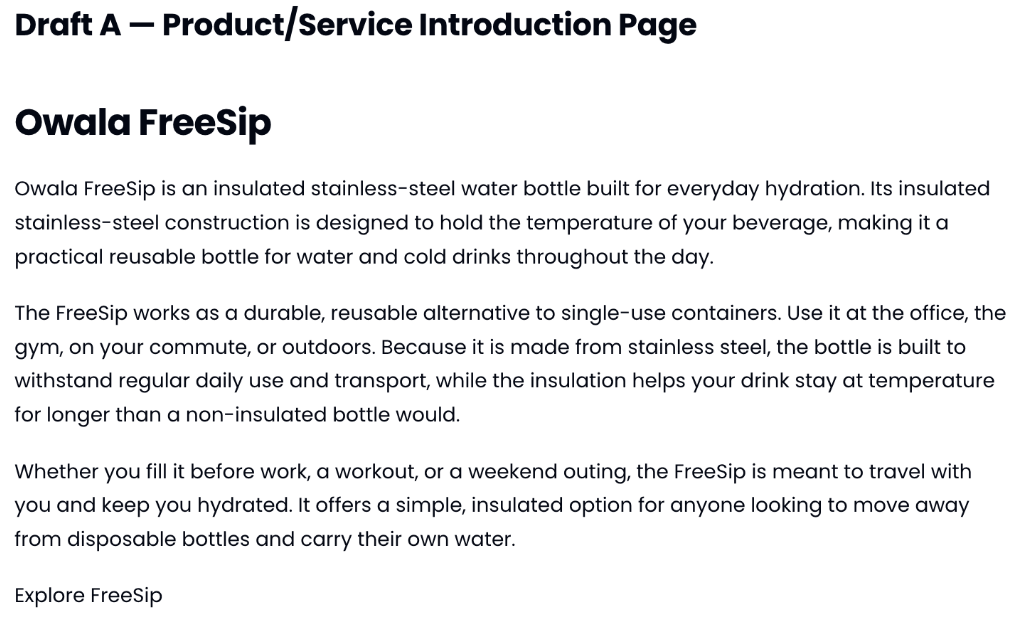
资料完整时,整体更准:6 篇里事实都有依据、要点和限制也没有漏写的篇数,ChatGPT 和 Copy.ai 都是 6 篇,Jasper 和 WRITER 各 2 篇。问题更隐蔽,往往出在读起来最像广告的那句话上。
营销文案 · 写得准不准
读起来很顺,但不能发的句子
资料完整时。左:资料怎么写;右:AI 写出的原句。
| 工具 · 稿件 | 资料怎么写 | AI 怎么写 | 问题 |
|---|---|---|---|
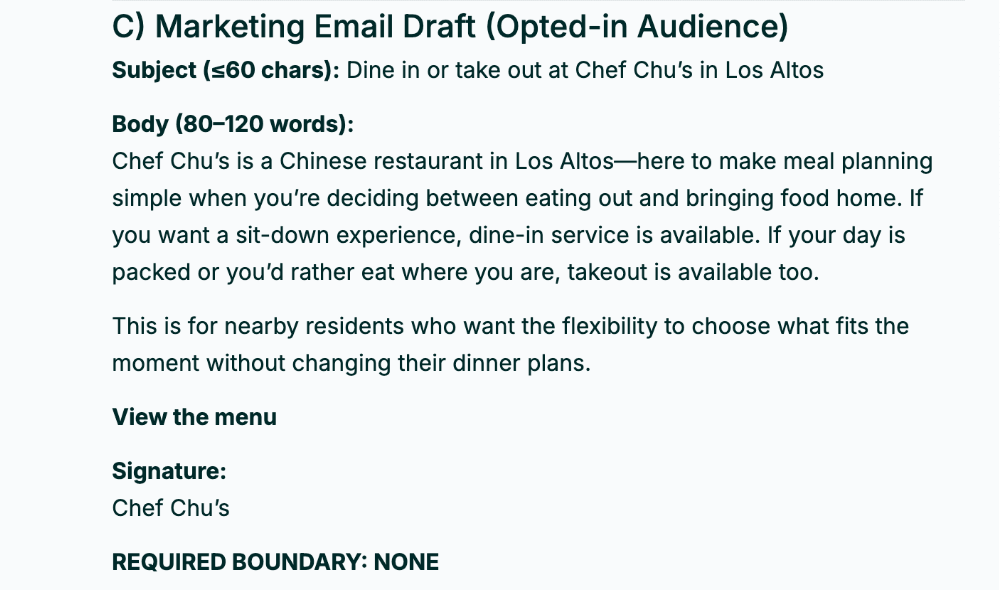
| JasperOwala 介绍页 | 内置吸管、较宽饮水口 | “a built-in straw for quick, hands-free sips” | 无依据功能 |
| JasperOwala 介绍页 | 没有任何读者提问 | “You asked how it works” | 虚构提问 |
| Jasper / WRITER营销邮件 | 群发给订阅用户 | “You asked: can you dine in…” / “You asked whether this model…” | 虚构提问 |
| WRITERChef Chu’s 介绍页、邮件 | 可以堂食,也可以外带 | “The same menu supports either choice / option” | 无依据说法 |
| Copy.aiChef Chu’s 邮件 | 没有这一句 | “REQUIRED BOUNDARY: NONE” | 内部说明外漏 |
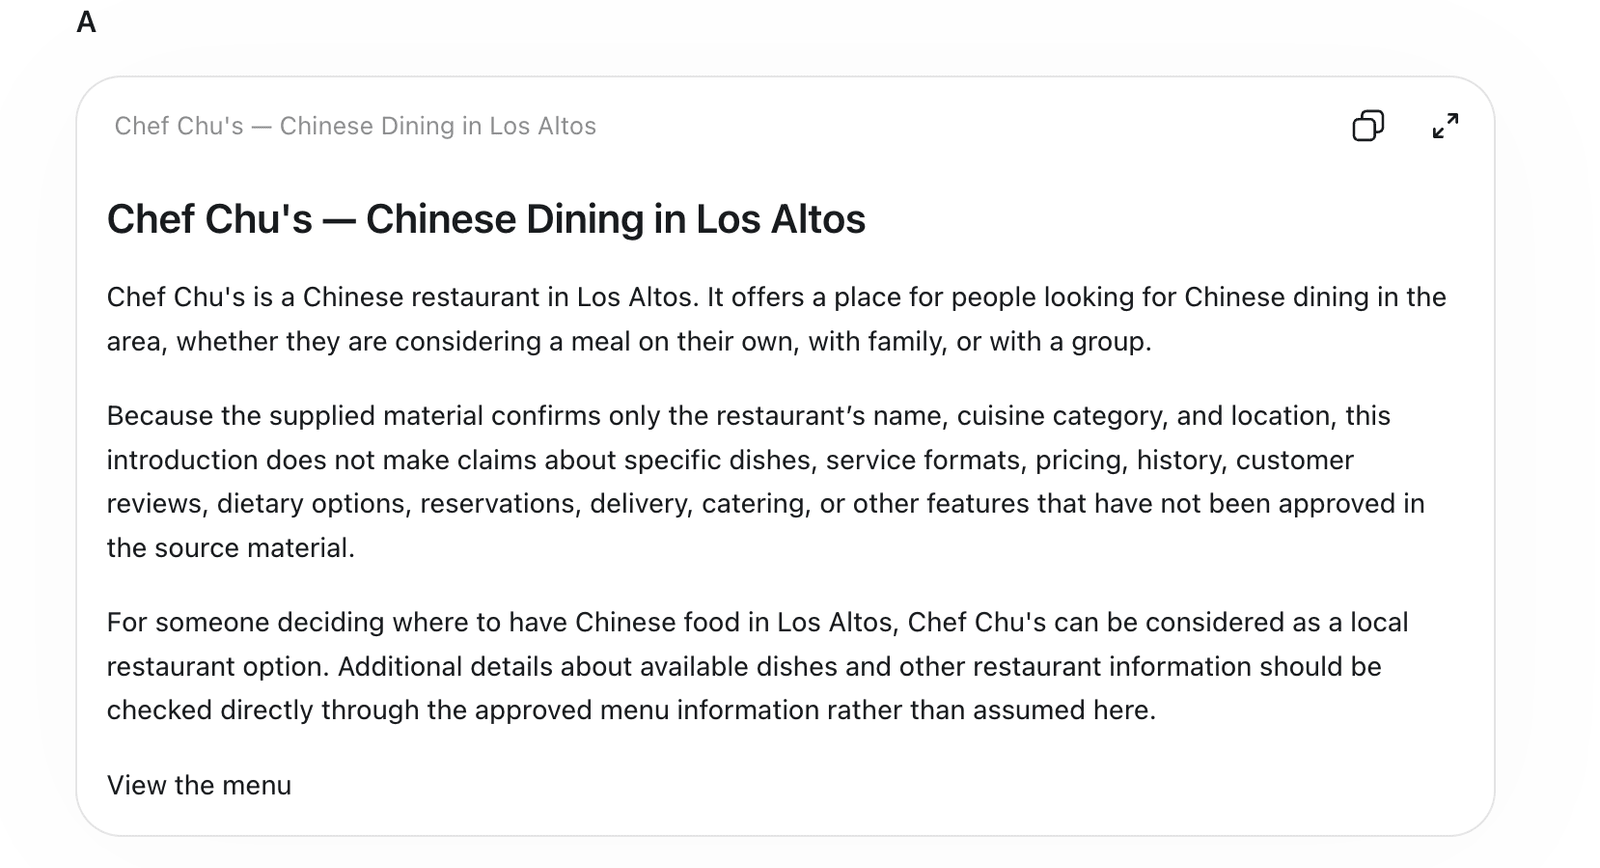
- ChatGPT 资料完整的 6 篇没有事实问题,但 Chef Chu’s 邮件有一句说明资料的话,计为内部说明外漏。
- 这些说法在现实中可能成立,本期只按收到的资料判断。高亮为本刊所加。
“内置吸管”被写成“免手持喝水”。 Owala 的资料只写了内置吸管和较宽的饮水口。Jasper 的介绍页写成“a built-in straw for quick, hands-free sips”。这句话读起来很顺,但资料没有说明它能免手持。要查的是:资料写的是一个部件,文案有没有把它写成了一项功能。
写出不存在的客户提问。 同一篇介绍页写着“You asked how it works”。Jasper 的 Chef Chu’s 邮件写“You asked: can you dine in, get takeout, or both?”,WRITER 的 Owala 邮件写“You asked whether this model can hold hot drinks”。后两篇是群发邮件,第一篇是公开的介绍页,都没有哪位读者真的问过这些问题。需要说明,测试指令要求工具回应一个买家常见问题,把这类写法算作无依据说法是本期的一条判定规则;如果放宽这一条,Jasper 的 Chef Chu’s 一组首稿会变为合格。发之前要查:凡是“You asked”这类句子,读者是否真的问过。
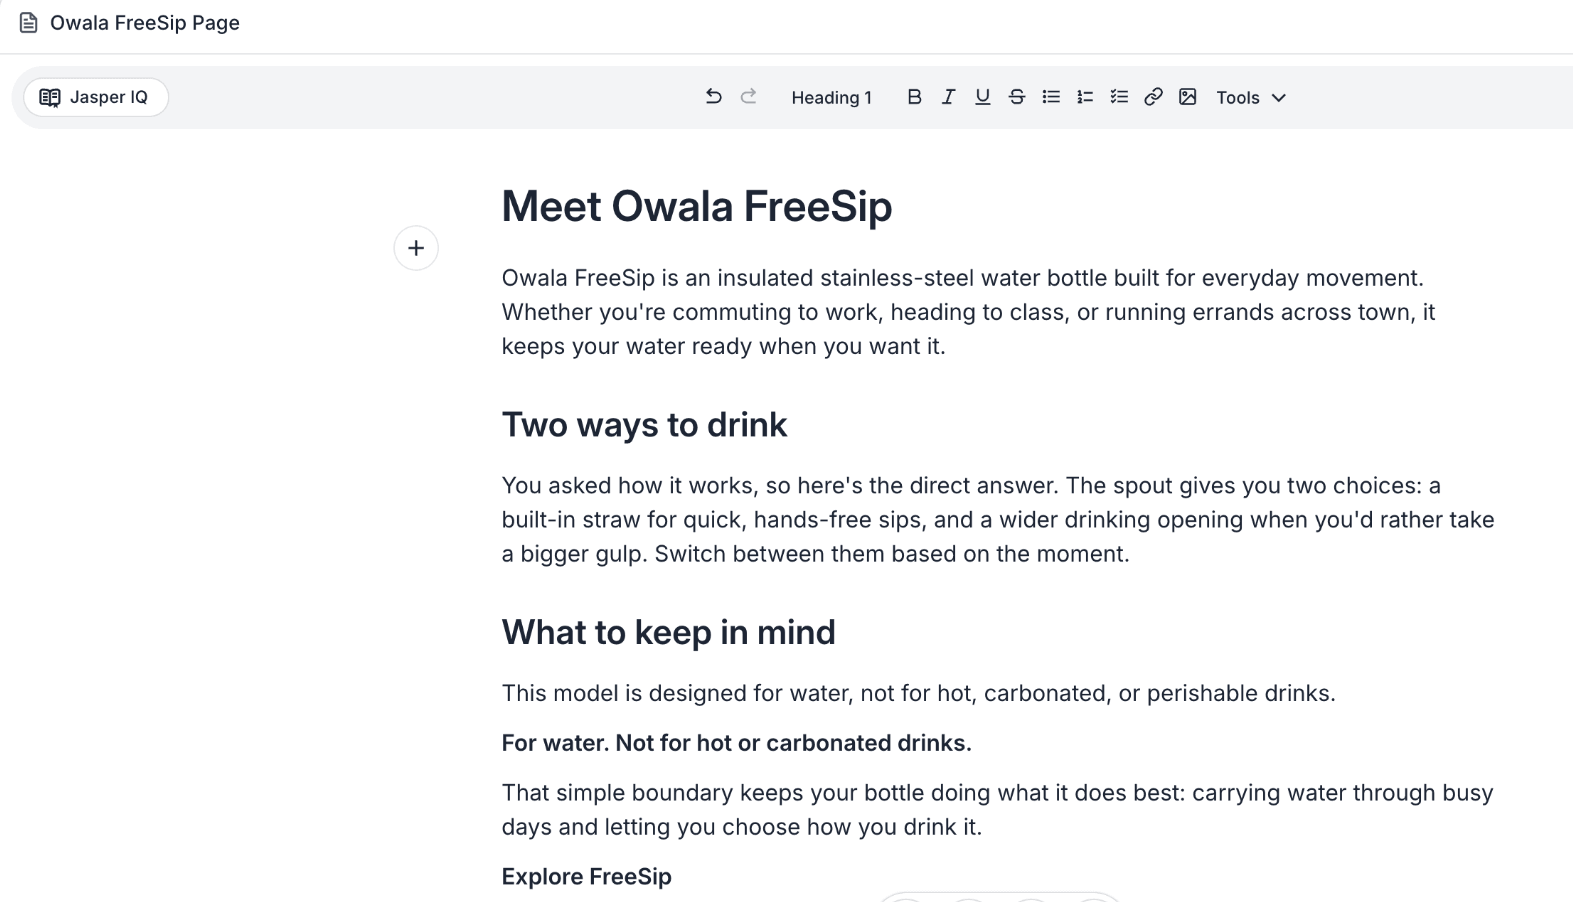
内部备注留在客户邮件里。 Copy.ai 的 Chef Chu’s 邮件,署名之后还留着“REQUIRED BOUNDARY: NONE”。这是给工具看的任务字段,不该出现在发给客户的邮件里。Copy.ai 资料完整的首稿和改稿共 12 篇,篇篇都印出了这个标签。它和下文 ChatGPT 说明资料的句子一样,都和测试指令要求附内部证据表、写入限制句有关;但读者拿到的稿件都必须先删掉才能发,本期对两者统一计为内部说明外漏。发邮件前,要查署名之后的最后几行。
ChatGPT 在这一关最稳,但也有需要删的句子。它会在正文里解释“资料只确认了什么、所以不写什么”。这类句子没有编造事实,但和 Copy.ai 的“REQUIRED BOUNDARY”一样属于把内部说明带进公开文案,本期同样计为不合格:ChatGPT 的 18 篇中有 9 篇出现(资料很少 6 篇,资料完整的 Chef Chu’s 邮件 1 篇,改稿 2 篇)。发之前,可以在正文里搜一下 supplied、information、material 这几个词,把这类句子找出来删掉。
第二关:AI 有没有把要求做全?
这一层看的是:文案有没有漏东西、少写东西、改坏东西。
- 字数是否达标;
- 产品限制是否保留;
- 指定内容是否都出现;
- 修改后有没有破坏原来的要求。
最常见的问题是字数。介绍页要求 120–180 词,社媒帖 60–100 词,邮件正文 80–120 词。资料很少时,ChatGPT 的 Owala 三篇只有 106、56、70 词,全部不达标。它没有乱编,代价是写不够。资料完整时,Copy.ai 的 Owala 介绍页也只有 113 词,低于下限。按同一分母(每款工具全部 18 篇),字数不达标的篇数:Copy.ai 10 篇,ChatGPT 3 篇,Jasper 1 篇,WRITER 0 篇。
营销文案 · 要求做没做全
5 篇字数没达标;ChatGPT 资料很少时写不够
灰色区间:要求字数。圆点:实际字数。空心点:改稿前字数。
- ChatGPT 资料很少时不编造,代价是写不够;越改越短的是 Copy.ai 的 Owala 邮件。
- 字数按空格分词统计,邮件只计正文。
把资料完整和资料很少两种首稿放在一起,共 12 篇。品牌名、引导语、字数都符合要求,而且没有留下内部说明(含说明资料的句子)的篇数,我们称为“格式规格达标”:WRITER 12 篇,Jasper 11 篇,ChatGPT 5 篇,Copy.ai 1 篇。若不把说明资料的句子计入,ChatGPT 为 9 篇。这个指标只看格式,不检查卖点和限制是否写全:WRITER 12 篇全部达标,但它的 Owala 社媒帖漏写了易腐饮品限制。
营销文案 · 要求做没做全
WRITER 的 12 篇首稿全部格式达标;Copy.ai 只有 1 篇
每格一篇首稿:品牌名、行动号召(CTA)、字数都符合要求,且没有留下内部说明。
达标若不计说明资料的句子则达标未达标
- ChatGPT:资料很少时 Owala 三篇字数不够,Chef Chu’s 三篇和资料完整的邮件有说明资料的句子。Jasper 有 1 篇字数不够。Copy.ai 主要是字数不够和“REQUIRED BOUNDARY”字段。
- 本指标只看格式,卖点和限制另行检查。
- 按产品名字母顺序排列,不代表名次。
- “最佳”标出每项指标的最好结果;并列时同样标出。
少写一条限制,同样需要返工。Owala 的资料写明,它不适用于热饮、碳酸饮料和易腐饮品。Jasper 和 WRITER 的社媒帖保留了热饮和碳酸饮料,漏掉了易腐饮品。读者看到那句话,可能以为限制已经写全了。发之前要把资料里的限制逐条对一遍,不能只看限制原句在不在。
营销文案 · 要求做没做全
Jasper 和 WRITER 漏写了“不适用于易腐饮品”
Owala 社媒帖。资料写明三项限制;方块依次为:热饮、碳酸饮料、易腐饮品。
写到漏写
- Jasper 和 WRITER 都写了限制原句“For water. Not for hot or carbonated drinks.”,但原句本身不含易腐饮品,需要另外补写。
- 按产品名字母顺序排列,不代表名次。
- “最佳”标出每项指标的最好结果;并列时同样标出。
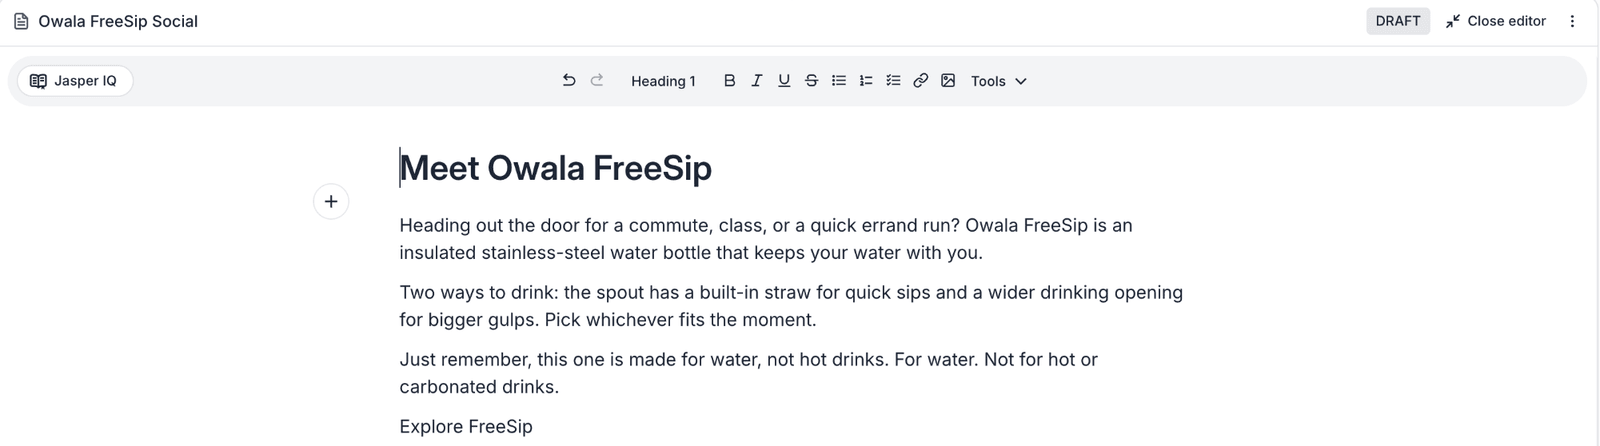
修改也可能把原来的要求改丢。Copy.ai 把 Owala 邮件正文从 85 词缩到了 76 词,原来达标的邮件,改完反而不达标了。改稿之后要重新数一遍字数。
第三关:AI 能不能针对不同渠道写出不同的内容?
同一份资料要分别写成官网介绍页、社媒帖和营销邮件。三篇应该说同一件事,但要按渠道写出不同的重点和写法,而不是同一段话换个格式。我们看:
- 是否符合指定渠道;
- 是否真的有内容区别;
- 是否只是换了开头,主体高度重复;
- 是否保留品牌和产品的核心信息;
- 是否看起来像一批可以分别使用的文案。
核心信息上,四款工具差别不大。我们检查三篇是否都写对了品牌名、产品是什么、主要卖点、使用限制和引导语,两个品牌共 10 项。ChatGPT 和 Copy.ai 10 项全对,Jasper 和 WRITER 各错 1 项(Owala 社媒帖漏写易腐饮品)。
差别在重复。WRITER 在第二关 12 篇首稿格式规格全部达标,但资料完整时的 6 篇里,有 2 篇超过一半内容与同组另两篇重合(Owala 社媒帖约 65%、邮件约 56%)。ChatGPT、Jasper 和 Copy.ai 都没有。56% 那篇离 50% 的阈值不远,阈值稍作调整就可能改变计数。
营销文案 · 不同渠道写得不一样吗
只有 WRITER 有文案和同组另两篇大半重复
每个点是一篇资料完整的文案:与同组另两篇的重合比例(连续五个词相同的片段)。实心点超过 50%。
- WRITER 超过一半的两篇约 65% 和 56%,后者离阈值不远。重合比例包含每篇必须出现的引导语和限制句,只能提示哪篇需要重写,不能判断哪篇写得更好。
- 按产品名字母顺序排列,不代表名次。
- 越少越好:“最佳”标出最少的结果;并列时同样标出。
格式通过,不等于每篇都值得单独使用。需要说明的是,重复程度里也包含了每篇都必须出现的引导语和限制句。它能提示哪些稿子需要重写,不能判断哪篇写得更好。
这次也没有使用完整的品牌手册,只能看文案是否符合品牌资料和任务要求,不能说哪款工具最懂品牌、语气最一致。
第四关:AI 改完稿之后,能不能直接用?
修改任务要求三篇同时换掉引导语,再换上指定的第一句。以 Owala 为例,“Explore FreeSip”要改成“See the two ways to drink”,产品信息、限制和字数要求继续保留。我们看:
- 有没有完成指定修改;
- 修改后有没有继续满足字数、事实和格式要求;
- 有没有改对一个地方,却破坏另一个地方。
四款工具都完成了指定的替换。差别在改完以后:6 篇改稿中,可以直接用的篇数为 ChatGPT 4 篇,Jasper 4 篇,WRITER 2 篇,Copy.ai 0 篇。改对且没有改坏原稿的篇数:Jasper 和 WRITER 6 篇,ChatGPT 和 Copy.ai 5 篇。按整组看,改完三篇全部合格的组,ChatGPT 和 Jasper 各 1 组(共 2 组),WRITER 和 Copy.ai 都是 0 组。
营销文案 · 改完能不能直接用
ChatGPT 和 Jasper:6 篇改稿中 4 篇可以直接用
每格一篇改稿。
可以直接用没改坏,但还不可以直接用改坏了
- 差距主要来自原稿的问题被原样带进改稿;ChatGPT 的 Chef Chu’s 介绍页改稿新加了一句说明资料的话,算作改坏。
- 整组改完全部合格:ChatGPT 1/2、Copy.ai 0/2、Jasper 1/2、WRITER 0/2。
- 按产品名字母顺序排列,不代表名次。
- “最佳”标出每项指标的最好结果;并列时同样标出。
差距主要来自原稿的问题被原样带进了改稿。Jasper 的 Owala 介绍页仍然写着“hands-free”。WRITER 的 Chef Chu’s 介绍页和邮件仍然写着“The same menu supports either choice / option”,而资料只说有堂食和外带,没说菜单相同。Copy.ai 的 Chef Chu’s 三篇仍然留着内部字段。多数工具只改了被要求改的两句,其余的错误没有被顺手修掉;ChatGPT 的 Chef Chu’s 邮件改稿仍保留说明资料的句子,介绍页改稿还新加了一句。所以审改稿时,不能只看被要求改的两句,要把原稿的问题再逐条查一遍。
营销文案 · 改完能不能直接用
改稿时,原稿的问题去哪了
只要求换行动号召和第一句;每一行跟踪一个原稿问题在改稿中的去向。
| 工具 · 稿件 | 原稿的问题 | 改稿之后 |
|---|---|---|
| JasperOwala 介绍页 | “hands-free sips”没有资料依据 | 仍然保留 |
| WRITERChef Chu’s 介绍页、邮件 | “The same menu supports either choice / option” | 仍然保留 |
| Copy.aiChef Chu’s 三篇 | 留下“REQUIRED BOUNDARY: NONE” | 仍然保留 |
| JasperChef Chu’s 邮件 | “You asked”虚构提问 | 已删除,改稿合格 |
| ChatGPTChef Chu’s 邮件 | “the supplied information confirms that both service options are available” | 仍然保留 |
| ChatGPTChef Chu’s 介绍页 | 原稿没有说明资料的句子 | 新加 “the available information confirms both”,改坏 |
- 多数工具只改了被要求改的两句,其余错误没有被顺手修掉。
也有反过来的情况。Jasper 在 Chef Chu’s 邮件里删掉了原稿的“You asked”,改稿反而合格了。而 ChatGPT 的 Chef Chu’s 介绍页改稿新加了一句 “the available information confirms both”,原稿没有,改完反而不合格。
本期没有评估什么?
我们没有测试真实发布后的打开率、点击率、转化率和销售结果,没有记录各工具的费用和生成耗时,也没有比较哪款工具写得更动人、更懂品牌。因此,这次测评只能回答“写得准不准、要求做没做全、文案能不能直接用”,不能回答“哪款工具最会卖”。
该怎么选?
- 如果你最怕 AI 编错产品信息,ChatGPT 在本次测试中事实最稳:资料很少时它没有写出无依据的说法。但改完的 6 篇里只有 4 篇可以直接用,与 Jasper 持平;正文里说明资料的句子在 18 篇中出现 9 篇,本期计为不合格。使用时要删掉这类句子,并单独检查字数。
- 如果你最在意按格式交稿,其他工具有局部优势。WRITER 的 12 篇首稿全部符合品牌名、引导语和字数要求,Jasper 有 11 篇;改稿时,这两款都完成了修改,也没有带来新问题。但资料之外的卖点和重复内容需要重点检查。
- 如果你看重资料完整时的准确和渠道区分,Copy.ai 也有长处:资料完整的 6 篇事实都有依据(与 ChatGPT 并列),三篇核心信息 10 项全对,三个渠道也没有大段重复。但它字数不达标和内部标签的问题最多,改完的 6 篇没有一篇可以直接用。
- 如果你想要一键生成、完全不审核,本期没有任何工具达到这个标准。四款工具都在至少一类任务里出现了需要人工处理的问题。
- 如果你关心哪款最能带来转化,本期测试还不能回答。
实际使用时,可以先拿一份自己熟悉的资料,让工具写完三篇,再提一次修改要求。然后对照原资料读完改稿,逐句确认哪些内容有依据,哪些地方需要补材料。这比只看第一版是否流畅,更接近日常审核。
写给批准订阅的人:这是一次初步比较,只测了两个品牌,每种情况各一次。如果团队已经在付费使用 ChatGPT,本期结果不支持为了“写得准”再加一份专业写作工具的订阅;WRITER 和 Jasper 的长处在按格式交稿、改稿不改坏,值得用自己的资料再试;Copy.ai 改完的 6 篇没有一篇可以直接用。无论选哪款,都要给团队留出对照资料逐句审稿的时间。
评测边界与结果说明
本期两个品牌各测一次,是计划中 6 个品牌、每个品牌测 2 轮的首批结果。测试资料固定于 2026 年 9 月 7 日,各工具的测试日期不同:三款专业工具约在 9 月 8–9 日测试;ChatGPT 是后来加入的通用大模型参照,不在原执行清单中,于 9 月 24 日测试,其中 Chef Chu’s 的资料完整首稿和改稿于 9 月 26 日重新提交(9 月 24 日收到的这两份文件混入了 Owala 的内容),本期按 9 月 26 日的文件评分。Claude 等其他通用大模型本期没有测试。WRITER 使用免费版,ChatGPT 记录标注为 Astra-Medium,Copy.ai 记录的模型为 GPT-5.2,部分套餐和运行设置信息未齐备。
测试指令禁止联网浏览,但 ChatGPT 的记录显示联网开启(截图中未见检索痕迹);其他工具的联网设置没有记录。Jasper 的改稿一次返回了三个版本,按规则只评第一个。ChatGPT 邮件主题在文字记录中缺失,按原始截图补录后评分。资料很少时写出无依据说法的组,原计划补全资料后再生成一次(补背景修复),本期没有执行。
AI 参与:由 AI 对照记录和评分标准逐项核查;评分规则由 analyst.ai 编辑决定。每篇的判定都记录了原句证据,没有评审一致率记录。正文中说明资料的句子(判例 J6)与 Copy.ai 印出的“REQUIRED BOUNDARY”标签(J9)一样,计为把内部说明带进公开文案(评分记录中记为 G3 项不通过),对四款工具统一适用;这条判例在评分过程中曾被取消,2026 年 10 月 10 日决定恢复。这两种外漏都和测试指令要求附内部证据表、写入限制句有关。若不计说明资料的句子,ChatGPT 的格式规格达标为 9/12,可以直接用的改稿为 6/6。正文把虚构的读者提问计为无依据说法,对应评分记录中的判例 J1。
资料很少时的无依据说法按一条统一规则判定(评分记录中的判例 J4):资料没有依据的服务和功能说法,计为无依据说法;工具建议的用餐或使用场合不计。因此,ChatGPT 的 Chef Chu’s 介绍页写“whether they are considering a meal on their own, with family, or with a group”,属于建议场合,不计,ChatGPT 仍为 0 条;Copy.ai 写“a place to dine in”,等于说餐厅提供堂食这项服务,计入。这条规则于 2026 年 10 月 10 日补写进方法,没有改变原有判定。
商业关系。 analyst.ai 与本文评测的任何产品都没有商业关系:没有赞助、付费合作、联盟链接,也没有厂商提供的账号或额度。
更正。 发现错误?更正记录与提交方式见 analyst.ai/corrections。
数据。 本文的评分表可在本页下载。部分原始输出已作为插图展示;全部原件将补入证据包。