---
title: "GEO 工具能告诉你,网站怎么改才更容易被 AI 提到吗?"
url: https://analyst.ai/zh/reviews/geo-tools-what-to-change/
language: zh-CN
alternate: https://analyst.ai/reviews/geo-tools-what-to-change/
publisher: "analyst.ai,替买家测 AI 软件的实验室"
review_date: 2026-10-11
status: preliminary
description: "ChatGPT 综合 70.1 分,九个品牌全部排第一;五款专业 GEO 工具中,只有 Peec AI 给出了达标的网站任务,且只覆盖九个品牌中的六个。"
data:
- https://analyst.ai/reviews/geo-tools-what-to-change/data/rankings.csv
- https://analyst.ai/reviews/geo-tools-what-to-change/data/site-scores.csv
---
# GEO 工具能告诉你,网站怎么改才更容易被 AI 提到吗?
> **结论先看.** 做第一次审查,先试 ChatGPT:九个品牌上综合分都最高。但它的提示词与评分标准对齐,输出也由 OpenAI 的系统评判。
>
> - **70.1 / 100** — ChatGPT 综合分,9 个品牌都排第一
> - **96.0 对 83.8** — 只看问题与诊断(满分 100):ChatGPT 对 Writesonic
> - **6 / 9 个品牌** — Peec AI 的行动建议在这些品牌上达标(专业工具中唯一)
>
> **够不够?** 做第一次审查,ChatGPT 可能已经够用;但它提出的每一项修改都针对品牌自己的页面,没有一项涉及争取其他网站的引用。
**署名 analyst.ai** · GEO 工具评测 01
AI 的回答推荐了竞争对手,却没提你的品牌。在让网站团队再加一页之前,你得先弄清两件事:这条回答到底说明了什么,改网站能不能解决它。这就是检验 GEO(生成式引擎优化)工具最实际的标准:对 AI 回答做一次审查,能不能帮你判断哪些事值得做?
## 简短回答:在这批记录里,很少做到
我们比较的五款专业 GEO 产品中,只有 Peec AI 给出了达到我们标准的任务,而且只覆盖九个品牌中的六个。ChatGPT——你的团队可能早就在付费使用的通用助手——在被直接要求给出带证据、带检验方法的修改建议时,表现更好。做第一次审查,它可能已经够用。但它提出的每一项修改都针对品牌自己的页面,没有一项涉及争取其他网站的引用。这是一次初步比较:每款产品只有一批留存记录,评分有 AI 参与。
## 结论:第一次审查,先试 ChatGPT
**如果你是品牌或增长负责人,要做第一次审查,我们首先建议试用 ChatGPT。** 在全部九个品牌上,它的综合分都是最高的。它领先最明显的是问题和诊断:只按这两项计分,它得 96.0,Writesonic 得 83.8。Writesonic 的诊断与它接近;Peec AI 是唯一拿到行动分的专业工具。
有两个条件左右了这个结果,用它之前先掂量:
- **ChatGPT 的提示词和评分标准是对齐的。** 我们要求它给出最多三项行动,每项都写明目标、具体行动、支持证据、可行性和验证方式。评分标准认定一项行动合格,看的是有没有目标、改动、证据和结果检验。专业工具没有收到同等指令,而 Writesonic 行动分为零,原因恰恰是缺少结果检验。所以行动分的差距,有一部分衡量的是“谁被要求填这一栏”。
- **OpenAI 两边都沾。** ChatGPT 的逐条输出由 OpenAI 的系统 Codex 在一轮新评审中判定;五款专业工具沿用的是更早的判定。被审查的九个品牌里,也有 OpenAI 自己的网站。
真正有用的产出,是一项网站任务:同事能追溯到一条留存的回答,对照业务核实,然后决定接受、修改还是否决。下面的案例会显示,ChatGPT 离这个结果更近,也会显示它的建议哪里仍需纠正。
这条建议只覆盖有记录的分析流程。监测、团队报告、成本和业务结果,需要另做评估。
## 排名
本次比较共有 **54 条产品–网站记录**:六款产品、九个品牌,每款产品的记录来自同一批次。运行日期和订阅套餐没有被一致记录。
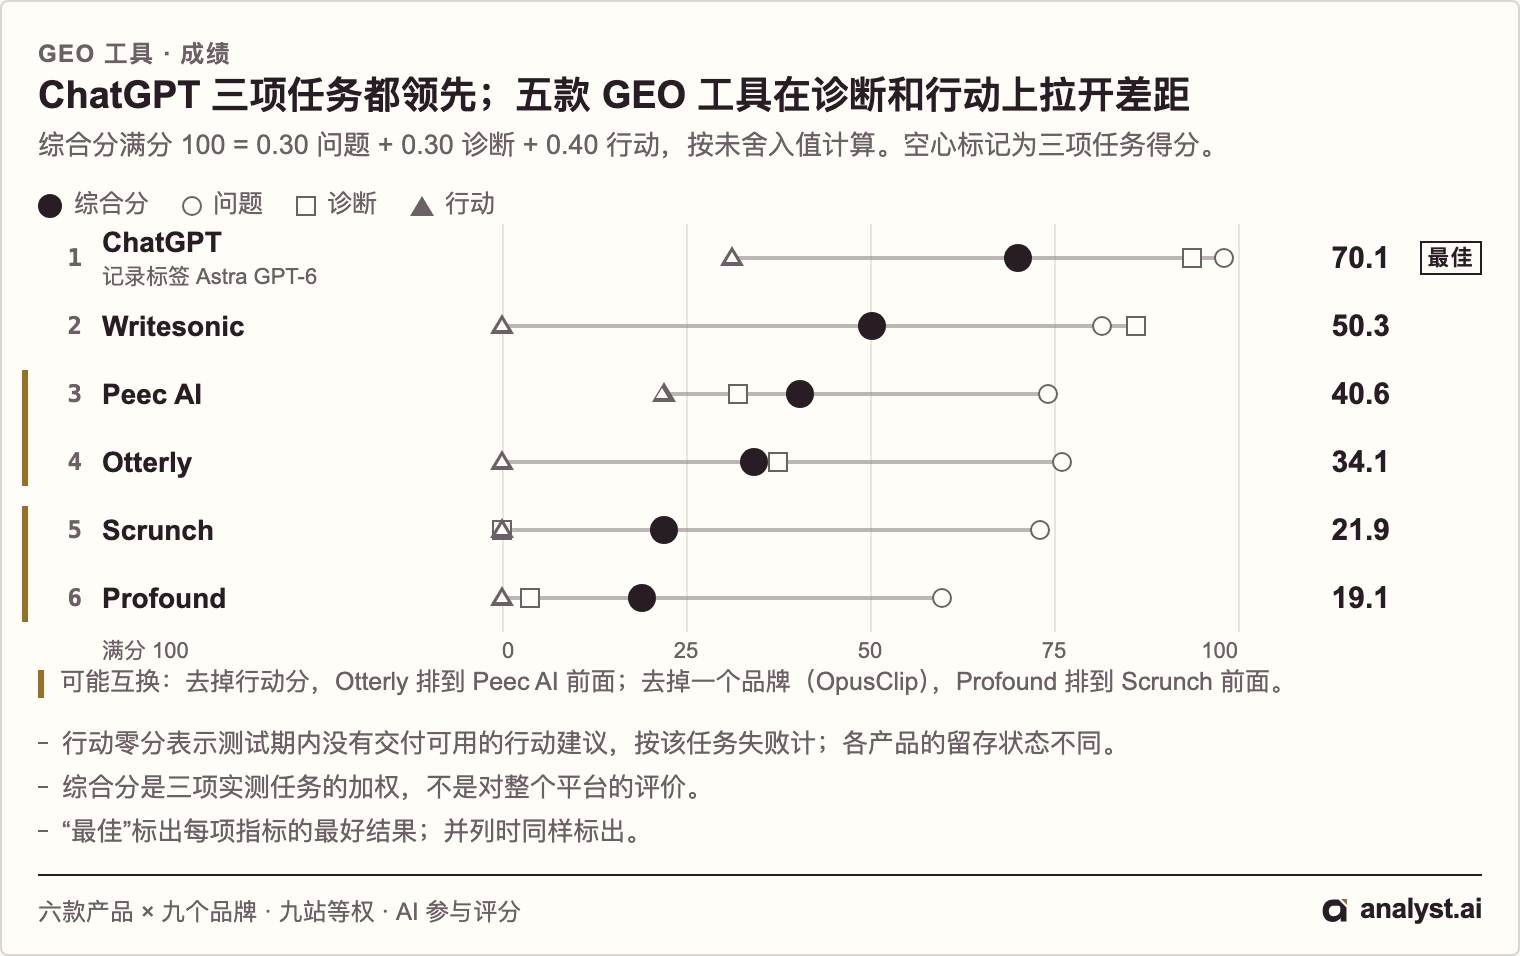
*图1. 各项满分 100,九个网站等权平均。综合分中问题占 30%、诊断占 30%、行动占 40%,用未舍入值计算。“Astra GPT-6”是所用 ChatGPT 模型的记录标签,确切版本没有记录。每款产品审查的是同一批品牌,但收到的指令不同(见“结论”)。[完整成绩卡](https://analyst.ai/assets/img/g01/scorecard-1520.4e5b95e594.png) · [分数数据](https://analyst.ai/reviews/geo-tools-what-to-change/data/rankings.csv)。*
这份排名要分梯队读。ChatGPT 在每个网站都排第一,各站综合分在 68.1 到 73.3 之间。Writesonic 在九个网站中的七个排第二。第三到第六名并不稳:去掉行动分,Otterly 会排到 Peec 前面;少算一个网站,Profound 会排到 Scrunch 前面。
行动零分的含义也各不相同:交付了建议但没达到标准(Writesonic),输出不完整(Otterly),或者流程还在等待、尚无输出(Scrunch)。
## 1. ChatGPT:最好的起点,但仍要人来把关
**综合 70.1 · 问题 98.1 · 诊断 93.8 · 行动 31.3**
ChatGPT 最好的案例,能把一道买家问题、一条留存回答和一项网站修改建议串起来。它的局限有两处:范围窄,所有建议都针对自有页面;还有一项建议把“更笃定的回答”当成了“更好的回答”。
### Chatbase:找出被漏掉背后的那道问题
两道没有点名品牌的问题,ChatGPT 在留存回答里推荐了其他客服产品,没有提 Chatbase。另一道把 Chatbase 和 Intercom Fin 放在一起比较的问题,却得到了对它能力的详细介绍。[1](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-1)

*图2. 三条留存 ChatGPT 回答的摘要,不是原始聊天截图。第三条是与 Intercom Fin 的正面对比。*
ChatGPT 的判断是:Chatbase 的公开内容,可能没有把产品能力和买家描述的任务清楚对应起来。第一道未点名问题,找的是能配合现有客服系统使用的工具——而对比回答恰好把这一点算作 Chatbase 的长处。委托做任何内容之前,先把回答引用的材料和相关页面对一遍:场景适配、引用来源和回答时间,同样可能解释这份候选名单。
### IRBIS:把“能不能被发现”和“点名提问”分开
ChatGPT 的 90 道问题全部被判为有用且不重复。但其中 64 道写了品牌名,只有 26 道没写。这两组回答的是不同的可见度问题,而 98.1 的问题分并不区分它们:应把它读作问题质量的分数,而不是“能否被发现”测试的分数。[2](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-2)
IRBIS HVAC 的一道问题问:更换热泵时,许可、验收和补贴手续由谁来办。它给了企业一个需要讲清楚的服务问题——但问题本身已经写出了公司名字。
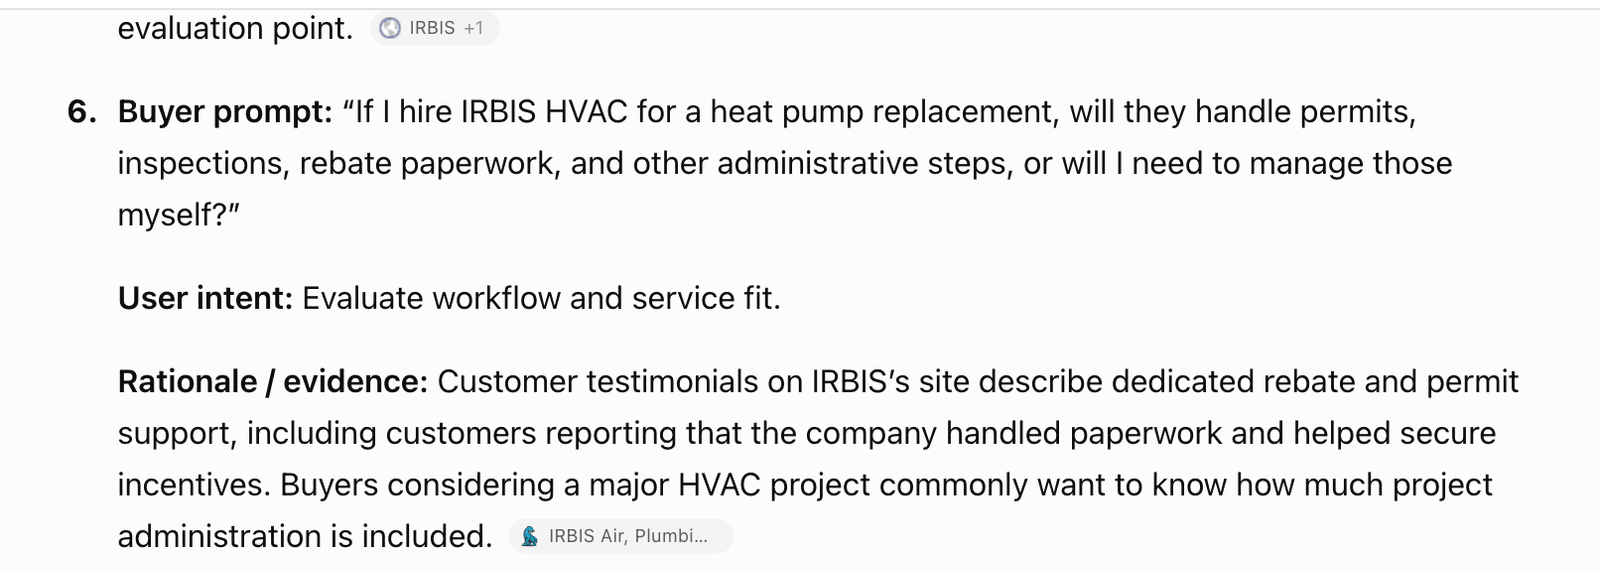
*图3. 留存的 IRBIS 问题原文节选(英文),含生成的理由说明。问题大意:“如果请 IRBIS HVAC 更换热泵,他们会代办许可、验收、补贴申请等手续,还是要我自己处理?”*
点名问题,用来检查 AI 怎样描述你的业务;未点名问题,用来测试买家能不能发现你。
### HeyGen:把回答变成一份需求说明
一条留存回答提到了 HeyGen,但对 Synthesia 培训流程讲得更充分。ChatGPT 对应的行动建议,是写一份端到端的 HeyGen 培训指南。它的要求具体得少见:[3](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-3)
> “The page should document actual behavior rather than just list features”
(大意:页面应记录产品的实际表现,而不只是罗列功能。)
它给的检验方法,是重新问原来那道问题,看回答对 HeyGen 工作流程的描述是否更完整。布置这份指南之前,先请产品负责人确认每项能力、所需套餐,以及哪些信息可以公开。重复提问也许能看到回答变了,却分不清这是页面修改的作用,还是模型、检索或时间的变化。
### Chef Chu:一项被评分否决的建议
ChatGPT 建议做一个服务详情页,涵盖外送餐饮、宴会、饮食限制和预订。它把成功定义为:回答里“请致电确认”这类保留说法变少。[4](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-4)
评分把这项行动算作 ChatGPT 的四项缺陷之一。过敏原交叉接触、当天能否接待、实时预订,本来就可能需要确认。应当发布餐厅能长期准确维护的服务政策和预订流程,并保留这些限定。如果回答更笃定,是因为删掉了顾客需要的那一步确认,它反而是更差的回答。
### 行动分说明什么
评分认可了 ChatGPT 27 项行动中的 23 项,另有 4 项算作缺陷。它的行动分仍只有 31.3,因为评分标准奖励对五类机会的覆盖广度,而这 27 项行动全部针对自有页面或内容。按公式,只覆盖一类且没有缺陷,得分是 33.3;缺陷再把平均分往下拉。[2](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-2)
这个上限反映的是真实的空白。ChatGPT 没有提出任何站外工作,比如争取媒体引用,而这正是专业工具宣称的主要价值所在。本次比较中单站行动分最高的,是 Peec AI 在 HeyGen 的 50.0:它把联系外部作者和一项自有页面任务结合了起来。
**试用决定:** 让 ChatGPT 给出一项页面修改建议、支持它的那条原始回答,以及页面负责人必须核实的事实。然后另外问它:这些回答依赖了哪些站外来源。
## 2. Writesonic:诊断接近,行动缺一环
**综合 50.3 · 问题 81.6 · 诊断 86.1 · 行动 0.0**
Writesonic 在问题和诊断上都排第二。在 OpenAI、HeyGen 和 IRBIS,它的诊断与 ChatGPT 持平或更好。56 条可读提示词中有 51 条被判为有用,而且它的清单比多数产品短,通常每个网站六条。留存的 HeyGen 界面把提示词标成 Branded(点名)或 Non-branded(未点名),挑选时就能看出“能否被发现”的区别。[2](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-2)
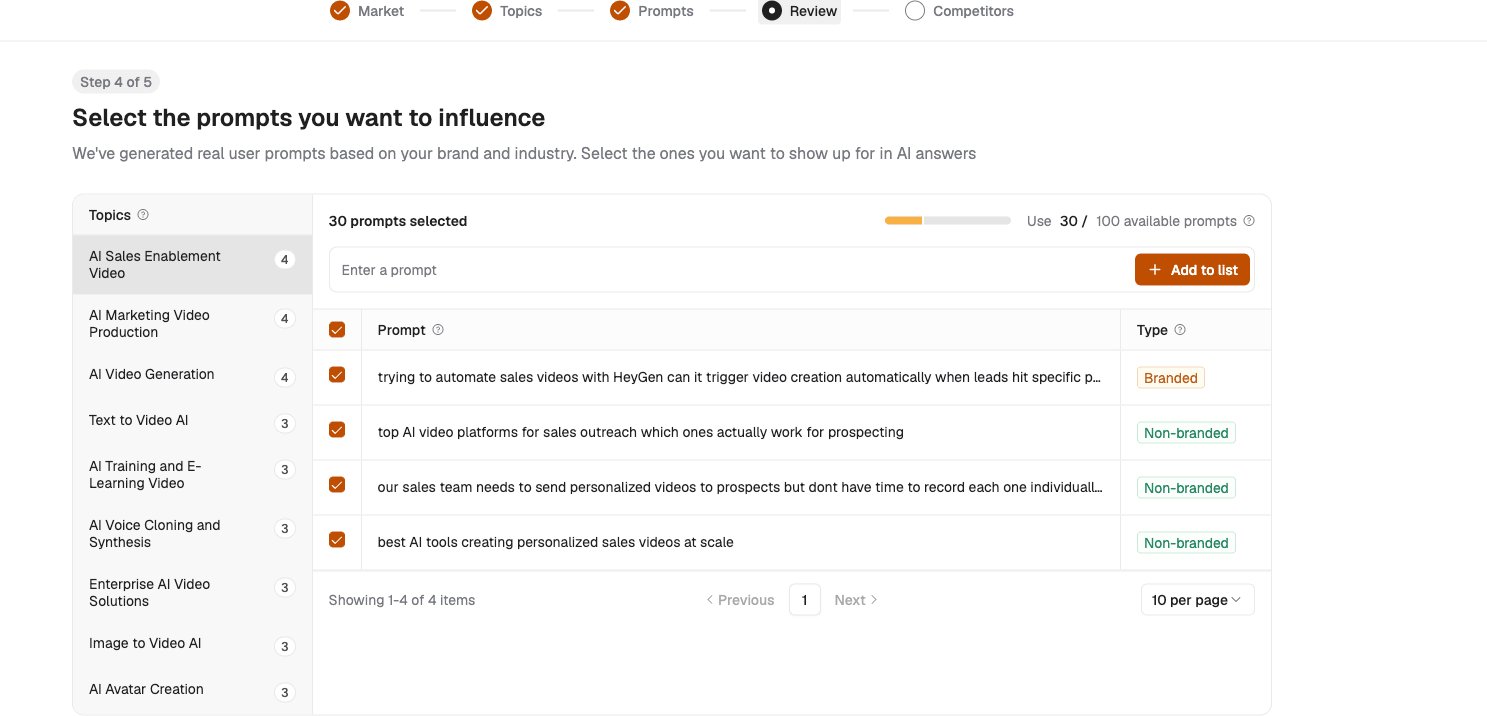
*图4. 留存的 HeyGen 界面(英文)。接受标签之前,先读一遍具体问法。*
它的行动分不能读成“没有建议”。具体建议是有的,但没有一条被判为包含足够的任务级结果检验;另有十二条被记为缺陷,其中六条在 Chef Chu。这六条无法在留存记录里逐一对上可查看的条目,所以这个数字只能算暂定。也别忘了:ChatGPT 被要求写结果检验,Writesonic 没有。[5](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-5)
**试用决定:** 拿一条诊断一路推到具体的页面修改,结果检验自己来写。Writesonic 的诊断让这个测试值得做;这批记录没能证明最后一步。
## 3. Peec AI:拿到了行动分,也有一个案例要推敲
**综合 40.6 · 问题 74.1 · 诊断 32.0 · 行动 22.0**
Peec AI 在九个品牌中的六个拿到行动分,这让它的综合分排到 Otterly 前面。它也有八项缺陷行动和五项错误诊断——在 IRBIS,它把公司自己的另一个名称当成了竞争对手。[6](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-6)
IRBIS 这个案例显示了这份得分的局限。留存的卡片记录了 AI 引用 AHS Home Warranty 一个页面的情况,把这个机会标为 **Low**(低优先级),并建议:
> “Create a category or tag page covering the same ground so your site becomes a citable source too.”
(大意:做一个覆盖相同主题的分类页或标签页,让你的网站也成为可被引用的来源。)
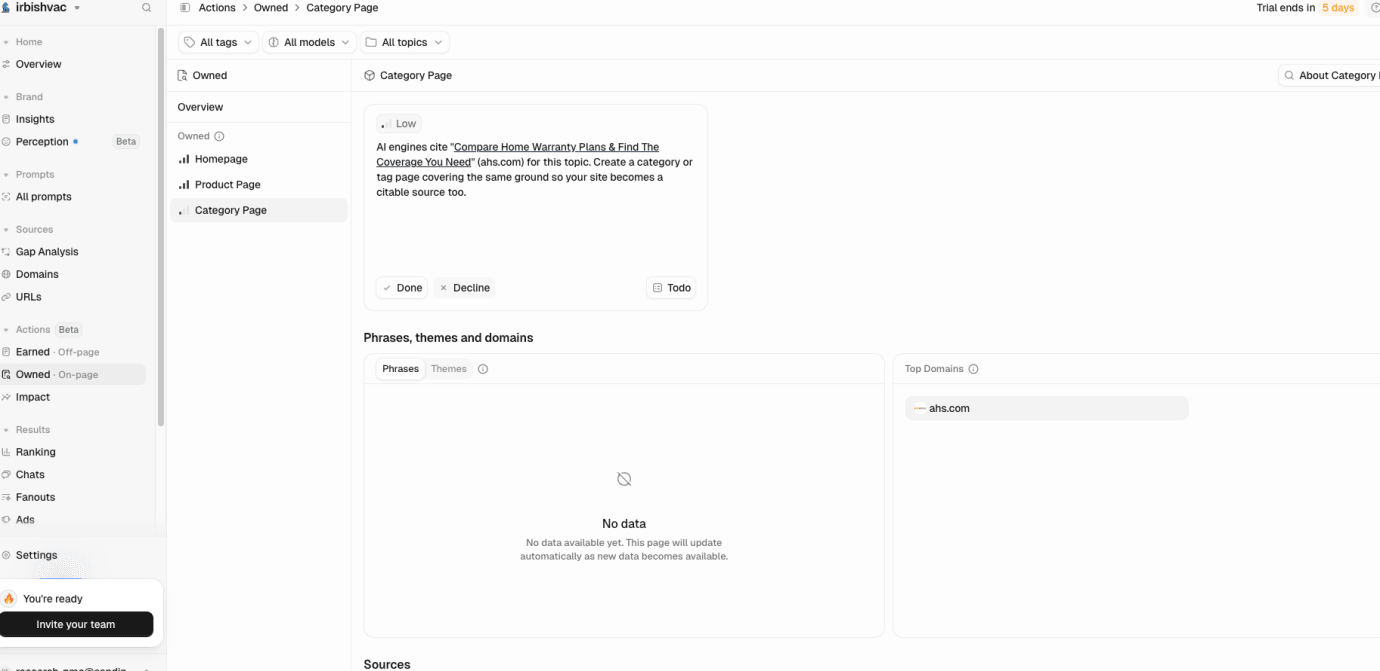
*图5. 留存的 IRBIS 行动卡片(英文界面)。*
这张卡片属于让 Peec 在 IRBIS 拿到行动分的任务之一。它写明了目标、改动和来源,而且 Peec 允许用户把行动标为已完成,之后再看结果。这项任务适不适合 IRBIS,评分标准没有问。布置页面之前,先确认 IRBIS 有没有类似的家庭保修服务;如果没有,就否决这项任务。
**试用决定:** 逐一打开被引用的页面,拿建议对照公司的实际服务。Peec 的得分说明它能产出格式完整的任务,不说明每一项都适合这家企业。
## 4. Otterly:问题能力比总名次显示的更强
**综合 34.1 · 问题 76.2 · 诊断 37.6 · 行动 0.0**
Otterly 在问题和诊断上都排第三,两项都领先 Peec。88 道可读问题中有 81 道被判为有用。如果你眼下要的是一份问题清单和初步诊断,第四名的综合分埋没了这项长处。[2](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-2)
留存记录里没有完整的行动建议。评分仍给每个网站计了一项缺陷行动,而这九项缺陷没有一项对应到具体条目。应把零分看作这一批次的不完整结果,把缺陷数看作未经核实——而不是这款产品能产出什么的证据。[6](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-6)
**试用决定:** 完整走一遍从选定问题到可用网站任务的路径。事先定好观察时长,并记录结果是已交付、仍在处理,还是要等后续监测。
## 5. Scrunch:问题生成看得到,行动流程还在等
**综合 21.9 · 问题 73.1 · 诊断 0.0 · 行动 0.0**
Scrunch 的 72 道可读问题全部被判为有用,但问题分只有 73.1,因为评分标准还奖励对买家需求的覆盖广度。问题清单再干净,覆盖的场景也可能很窄。[2](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-2)
这批记录没有拿到诊断分,行动流程则在等监测变化来触发建议。对需要马上派出一项任务的营销人员来说,这批记录没有展示出这样的任务。
**试用决定:** 弄清楚什么事件会触发建议,等它发生时把输出保存下来。如果你真正需要的是持续监测,就直接评估那套流程。
## 6. Profound:认对了业务,表现就很强
**综合 19.1 · 问题 59.9 · 诊断 3.7 · 行动 0.0**
Profound 的问题分掩盖了一个两极分化。在五个网站上,它的问题得分在 91.7 到 100 之间,在 OpenAI 和 Synthesia 与 ChatGPT 持平。在 Chef Chu、IRBIS 和 OpusClip,它的 61 道问题没有一道被判为有用,这三个网站都是零分。[2](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-2)
留存的 IRBIS 界面显示了问题出在哪里:给一家暖通空调企业生成的,是生鲜杂货、美容服务和餐厅预订方面的问题。其中一条是:
> “Where to book the best value beauty and salon appointments locally?”
(大意:在本地哪里能约到最划算的美容美发服务?)
[查看留存的 Profound IRBIS 截图](https://analyst.ai/assets/img/g01/profound-irbis-1600.92eef0efca.png)。
界面证明了业务错配,但说明不了原因出在输入、设置还是工具的理解。Profound 在九个网站上还只有一项有依据的诊断,没有合格的站点行动;三个本地服务网站上的六项缺陷行动,缺少条目级归属。[6](https://analyst.ai/zh/reviews/geo-tools-what-to-change/#source-6)
**试用决定:** 看任何结果之前,先确认项目认对了业务。在认对的地方,这些记录显示它的问题集和领先者一样强。
## 拿一项修改建议走完整套审查
无论试用哪款工具,都可以用同一套实际检验:
1. **选一道买家问题。** 标明它是点名品牌,还是测试能否被发现。
2. **保存完整回答。** 记下问题、日期和可见来源;“被漏掉”和“说错事实”分开记。
3. **写清修改建议。** 指明哪个页面、要补充或更正什么信息,以及支撑这项任务的那条回答。
4. **核实业务和产品事实。** 确认服务、能力、所需套餐和必要的限定条件。
5. **接受、修改或否决。** 同事应该能凭证据讲清这个决定,而不必把对话重新翻一遍。
周期性监测、跨 AI 平台的历史记录和客户报告,可能从第一天起就很重要。请单独试用:本次比较没有衡量监测质量、人员时间或成本。
**如果你负责审批订阅:** 先问团队,有没有用手头可能已有的 ChatGPT 套餐做过一次审查。在这批记录里,它三项任务都领先。专业 GEO 工具接下来要证明的,是我们没有测试的部分:周期性监测、跨 AI 平台的历史记录、客户报告,以及它在费用和人员时间上的成本。
## 方法与披露
**范围。** G01 v5.2 覆盖六款产品、九个品牌:OpenAI、HeyGen、Synthesia、Listen Labs、Chatbase、OpusClip、New England Lobster、Chef Chu 和 IRBIS HVAC。2026 年 9 月 18 日是基线汇总日期,不是统一的运行日期。运行日期、模型版本和订阅套餐没有被一致记录,也无法从留存记录中恢复。这 54 条产品–网站记录,是每款产品一个批次的留存输出,不是标准化或重复进行的试验。
**提示词。** 我们要求 ChatGPT 为每个网站生成恰好十道问题,并给出不超过三项优先行动,每项包含 Target、Specific Action、Supporting Evidence、Feasibility 和 Validation(目标、具体行动、支持证据、可行性、验证)。问题提示词不要求写出品牌名。专业工具通过各自的工作流程使用,无法确认它们收到了同等指令。
**分数衡量什么。** 问题分结合有用性和对十二类买家需求的覆盖。诊断分和行动分奖励对五类机会的覆盖,并因缺陷扣减:A = 100 × 2TA / (2TA + FA + MA),其中 TA 是有合格行动的类别数,FA 是缺陷行动数,MA 是未覆盖的类别数。98.1 分不是正确率百分比。
**各产品缺陷。** 缺陷行动:ChatGPT 4、Writesonic 12、Peec AI 8、Otterly 9、Profound 6、Scrunch 0。错误诊断:Peec AI 5、Profound 5、Writesonic 2、Otterly 2,ChatGPT 和 Scrunch 为 0。Otterly 的 9 项、Profound 的 6 项,以及 Writesonic 在 Chef Chu 的 6 项缺陷,在留存记录中没有对应到具体条目。
**评分来源。** ChatGPT 的逐条判定由 Codex 做出;专业产品沿用更早的 v5.2 判定,并重新核算了算术。Codex 和被评测的 ChatGPT 系统都来自 OpenAI。这是有 AI 参与的编辑评估。算术正确,并不能证明底层判定成立。
**敏感性。** 三项任务等权时,综合排名顺序不变。去掉行动分,Otterly 排到 Peec 前面;去掉 OpusClip,Profound 排到 Scrunch 前面。所有情形下 ChatGPT 都排第一。这些检验改变的是权重和网站,不能证明判定成立,也不能说明重复运行是否可靠。
**结果。** 本次比较没有实施任何建议,也没有衡量由此带来的可见度、访问、线索或收入变化。建议的网站修改及其检验方法,仍只是建议。
**数据。** 本文的评分表可在本页下载。部分原始输出已作为插图展示;全部原件将补入证据包。
**商业关系。** analyst.ai 与本文评测的任何产品都没有商业关系:没有赞助、付费合作、联盟链接,也没有厂商提供的账号或额度。测试账户由团队成员自行注册;各账户的订阅档位没有记录。
**更正。** 发现错误?更正记录与提交方式见 [analyst.ai/corrections](https://analyst.ai/zh/corrections/)。
下载:[六款产品结果(CSV)](https://analyst.ai/reviews/geo-tools-what-to-change/data/rankings.csv) · [54 条产品–网站数据(CSV)](https://analyst.ai/reviews/geo-tools-what-to-change/data/site-scores.csv)
### 分项成绩图

*买家问题。问题有用性和需求覆盖都计入分数。*

*机会诊断。分数反映有依据的类别和保留的缺陷,并非逐一独立核实了所有外部事实。*
### 案例来源
以下记录编号指向留存原件,这些原件将补入证据包。
**[1] Chatbase。** N02-V01 问题和回答;N02-V02 问题和回答;N02-V03 问题和回答;记录的诊断。
**[2] 计数与判定。** [产品层分数和分母](https://analyst.ai/reviews/geo-tools-what-to-change/data/rankings.csv);[网站层分数](https://analyst.ai/reviews/geo-tools-what-to-change/data/site-scores.csv);ChatGPT 点名/未点名问题和行动计数;ChatGPT 行动判定台账;IRBIS 问题,含 L03-Q06。
**[3] HeyGen。** B02-V08 问题、留存回答,以及完整行动输出中的 B02-A01。
**[4] Chef Chu。** 完整行动输出中的 L02-A03 及其缺陷判定。
**[5] Writesonic。** 留存证据审计和行动评分补充说明。上文的界面图按收到时原样保留,不是新的产品运行。
**[6] 专业工具的网站判定。** Peec AI、Otterly 和 Profound 留存的网站层判定,包括获认可和有缺陷的行动类别及备注。