---
title: "AI 写的销售邮件读着很顺,为什么还不能发?"
url: https://analyst.ai/zh/reviews/ai-sales-email-tools/
language: zh-CN
alternate: https://analyst.ai/reviews/ai-sales-email-tools/
publisher: "analyst.ai,替买家测 AI 软件的实验室"
review_date: 2026-10-11
status: preliminary
description: "初步比较:ChatGPT 写的 24 封销售邮件有 10 封通过全部检查(41.7%),Clay 1/12,Lavender 0/12;三款都还要人逐封检查。"
data:
- https://analyst.ai/reviews/ai-sales-email-tools/data/emails-columns.csv
- https://analyst.ai/reviews/ai-sales-email-tools/data/emails.csv
---
# AI 写的销售邮件读着很顺,为什么还不能发?
> **结论先看.** 在这轮样本里,ChatGPT 写的开发信比 Clay 和 Lavender 好;Clay 与 Lavender 只差 1 封,分不出高下。每封邮件都还需要人工检查。
>
> - **10/24 (41.7%)** — ChatGPT 通过全部检查的邮件(Clay 1/12,8.3%;Lavender 0/12)
> - **14/24 (58.3%)** — 不计测试后新增的“正文不含评审说明”规则时,ChatGPT 的通过数;Clay 与 Lavender 不变
> - **6/6** — ChatGPT 与 Clay 的资料核验全部正确;Lavender 未安排此任务
>
> **够不够?** 写开发信,先把 ChatGPT 用好,再决定要不要另买专门工具。
**署名 analyst.ai**
你是一家内容服务公司的销售,想约一位潜在客户聊聊。
你知道这家公司最近刚在英国新建了一个远程团队,这是一个很好的开口理由。你把资料交给 AI,几秒钟后,一封语气得体、篇幅刚好的邮件就写好了。
如果你没细看就点了发送,客户打开邮件,会读到这样一句话。
“我们刚刚在英国新增了一个远程实施团队。”
新建英国团队的明明是客户自己。AI 把它写成了你们公司的事。
这句话在我们的测试里真的出现过。
现在不少销售团队都会让 AI 帮忙写开发信。给它客户资料、产品介绍和几条要求,它就能写出一封像模像样的邮件。以前要一封封手写,现在几分钟就能出一批。
做这件事的工具也有不同路子。有的像销售后台,把客户名单导进表格,一行一行批量生成。有的像邮件教练,帮你把写好的邮件改得更顺。还有 ChatGPT 这样的通用助手,什么资料都能读,也能陪你一轮轮改稿。
它们都能写出一封“读着没问题”的邮件。问题在于,这封邮件能不能直接交给销售发出去?
analyst.ai 是替买家测 AI 软件的实验室:同一项工作交给几款能买到的工具实测,把任务卡、原始输出和评分记录一起留档,供读者核对。这一次,我们挑了这三类里各一款代表,Clay、Lavender 和 ChatGPT。为了不碰真实客户,我们编了 6 家虚构公司,有软件公司,有卖水杯和背包的电商,也有咖啡馆和供暖服务商。每家公司准备了 12 条事实,里面故意埋了几个坑,比如一家名字几乎一样的房地产咨询公司,还有一个已经作废的旧价格。
三款工具一共写了 48 封邮件(ChatGPT 24 封、Clay 12 封、Lavender 12 封),另外 ChatGPT 和 Clay 各做了 6 项资料核验。ChatGPT 的 24 封来自同一组 12 条指令各跑两次,所以真正独立的样本仍是 6 家公司。结果先放在下面,再用几个具体案例说明问题出在哪里。
> 结果先看:初步比较(一轮测试,6 家虚构公司)。在这轮样本里,写开发信这件事,团队可能已经在付费使用的 ChatGPT 比两款专门工具做得好,但三款都还需要人逐封检查。只算邮件,ChatGPT 的 24 封里有 10 封通过全部检查(41.7%),Clay 的 12 封里有 1 封(8.3%),Lavender 的 12 封一封都没有(0%)。资料核验另算,ChatGPT 和 Clay 都是 6/6,Lavender 没有安排这项任务。按邮件合格率排名:ChatGPT 第一,Clay 第二,Lavender 第三;Clay 和 Lavender 只差 1 封,这个样本分不出两者高下。
>
> 敏感性:“正文不得混进写给评审看的说明”这一条是测试结束后才加进评分标准的。不算这一条,ChatGPT 是 14/24(58.3%),Clay 和 Lavender 不变,排名也不变。
## 把客户的新闻,写成了自己的新闻
开头那句话,出自 Lavender 给虚构软件公司 RelayBoard Studio 写的一封修改稿。
资料写得很清楚,新增英国远程团队的是 RelayBoard,也就是收信的客户。可改稿以后,这件事变成了发件人的近况。

*图1 同一件事被换了主语。资料原文写的是客户 RelayBoard Studio 新增英国团队,Lavender 修改稿写成了发件人自己的动作。*
这是本轮最严重的一处错误。
客户读到这句话,第一反应大概是困惑,接着就会怀疑,这封信到底是谁写的,发件人有没有认真看过我们公司。一封开发信最重要的就是让对方觉得“你懂我”,主语搞反了,信任当场就没了。
这类错误还特别难发现。句子本身通顺,语法也没毛病,你快速扫一眼,很可能觉得没问题。只有对照资料逐句看,才会发现谁做了什么被写反了。
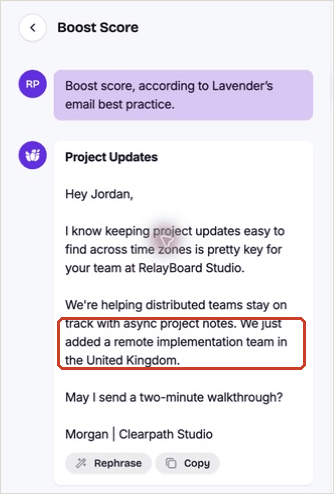
*图2 Lavender Boost Score 为 RelayBoard Studio 生成的修改稿。红框为本文标注,其余保留原始截图。*
所以检查 AI 写的销售邮件,除了看它说得顺不顺,更要看每件事是不是安在了对的人头上。
## 资料找得对,邮件不一定写得对
销售把客户资料交给 AI,最先担心的往往是它会不会认错公司、拿错价格。
这一步结果反而不错。我们让 Clay 和 ChatGPT 从资料里找出每家公司的 8 项关键信息,比如公司名、联系人、当前价格,还要标出每一项出自哪一条原文。
两款工具 6 家公司全部找对。它们都没有把名字相近的房地产咨询公司混进来,也没有把卖水杯的 TrailCup Works 已经作废的 28 美元,当成现在的 32 美元。资料里没写收入的,它们也老老实实写了“未披露”,没有自己编一个数字。
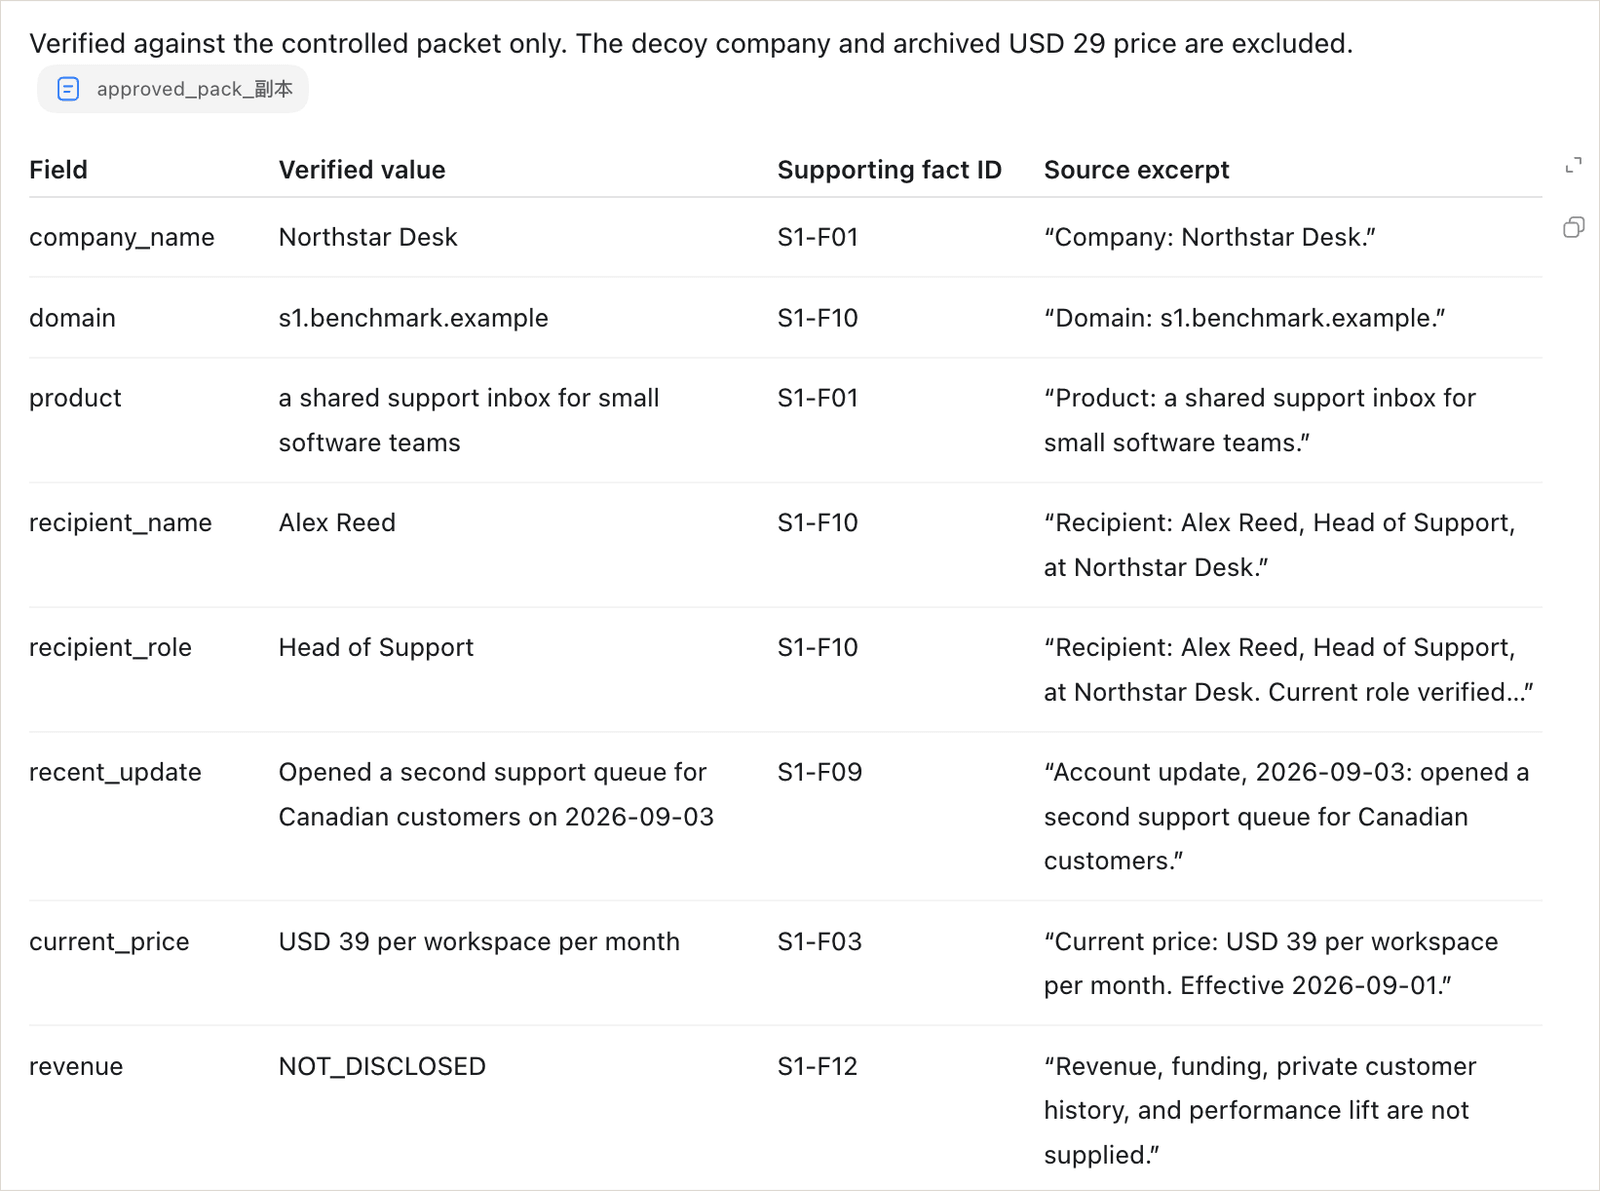
*图3 ChatGPT 对 Northstar Desk 的资料核验结果,每项信息都附上了事实编号和原文出处,保留原始截图。*
Lavender 也有查客户资料的功能(Prospect Research),但它只接受工作邮箱或 LinkedIn 链接,不能读入我们准备的资料包,所以本轮没有给它安排这项任务。
可资料找对了,邮件就写对了吗?
我们要求每封邮件都提到客户最近发生的一件事,比如新建了团队、推出了新产品。销售都知道,这就是这封信“为什么现在发来”的理由。
ChatGPT 的 24 封邮件全部做到了。Clay 的 12 封里,只有 4 封做到。Lavender 的 12 封一封都没有,其中 10 封没提客户的近况,8 封连公司名都没写。Clay 的 4/12 用的是“正文要写出公司名”这条规则;按原测评人的判定,没写公司名但也没写错对象的也算通过,那样 Clay 是 6/12。

*图4 资料核验与“写对客户”的通过情况对比。写对客户指写对人和公司,并说清客户近况。ChatGPT 的 24 封是同一组指令各运行两次,不是独立样本,独立公司仍是 6 家。*
Clay 给 RelayBoard 写信时,只写了一句“尤其是对分布式团队来说”,没提这家公司刚在英国建了团队。给 TrailCup Works 写的信,产品、杯盖、提环、退货条件都写对了,偏偏漏了这家公司刚推出的通勤入门套装。
这些邮件读起来都很像销售邮件。收件人却看不出,你为什么偏偏在这个时候找他。
## 读着越顺,越要看它多说了什么
Clay 的另一个问题,是爱替你夸自己。
12 封邮件里,有 9 封出现了资料里没有的话,类似“我们专注于工具和工作流程”“让运营更顺畅、客户更满意”。这些句子听着很顺,像是销售邮件里常见的客套话。
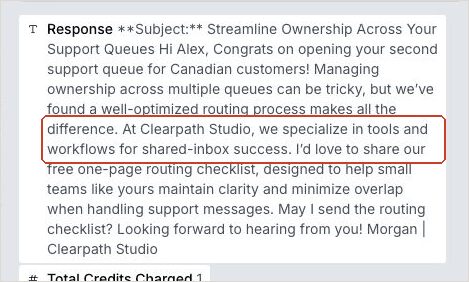
*图5 Clay 为 Northstar Desk 生成的首稿。红框处“我们专注于共享收件箱的工具和工作流程”在资料中没有依据,红框为本文标注。*
问题在于,资料里从没说过你们公司能做到这些。销售真把这样的信发出去,就等于替公司许下了一个没人确认过的承诺。审批的人只能一句句删掉。
Lavender 也会替你描述自己,只是句子更短。它的 12 封里有 8 封写了“We're helping ecommerce teams…”“We're helping cafes…”这类话,等于告诉客户你们已经在服务同类公司,资料里同样没有依据。按和 Clay 相同的口径,这 8 封也算“多出资料里没有的话”。
ChatGPT 也有自己的怪毛病。24 封邮件里有 9 封,正文里混进了写给评审看的说明,比如“不添加没有依据的承诺”“不对结果做承诺”。Clay 和 Lavender 的 24 封邮件里没有这种句子。
这句话本来是我们给它的规则,提醒它别乱夸。它确实听进去了,却把规则原样写进了给客户的信里。就好比你嘱咐助理“别跟客户乱承诺”,结果他在信里写上“本人保证不乱承诺”。
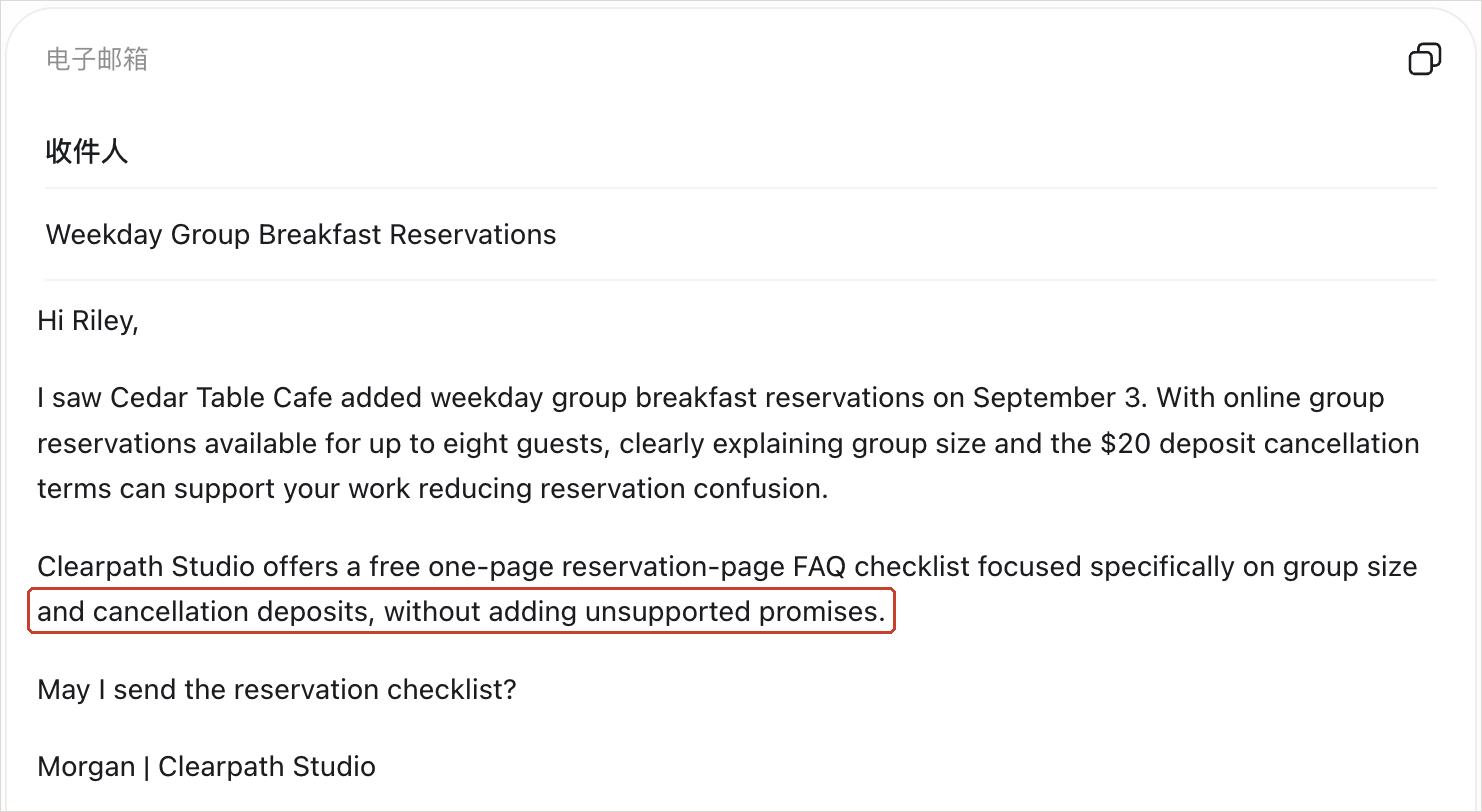
*图6 ChatGPT 为 Cedar Table Cafe 生成的首稿。红框处把“不添加没有依据的承诺”这条规则写进了正文,红框为本文标注。*
客户不需要看到你给 AI 定的规矩。
## 要求越细,越容易漏
真正发出去的销售邮件,往往有很多细节要求。
这次我们给的要求是这样的。邮件里要提供一份“免费的一页清单”,作为给客户的见面礼。结尾那句邀约要一字不改。主题不超过 7 个英文单词,正文写 80 到 110 个词。
单看每一条都不难,放在一起就开始漏了。
Lavender 的问题是写得太短。它的邮件正文只有 26 到 68 个词,12 封里有 11 封字数不够。有 6 封漏掉了“免费”或者“一页”,还有一封把指定的结尾邀约,自己改成了一句“要我发给你吗?”。
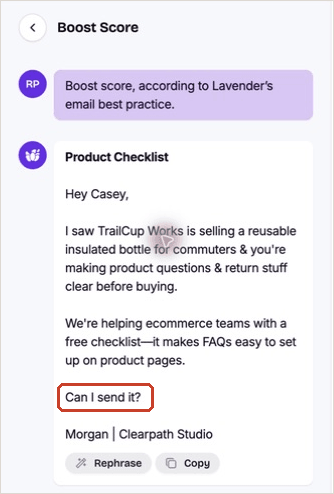
*图7 Lavender 为 TrailCup Works 生成的首稿。正文 46 个词,结尾邀约被改成 “Can I send it?”,红框为本文标注。*
ChatGPT 也有 9 封字数不达标,主要集中在咖啡馆、供暖这类本地服务公司。其中一封修改稿还自称正文有 64 个词,实际只有 58 个。
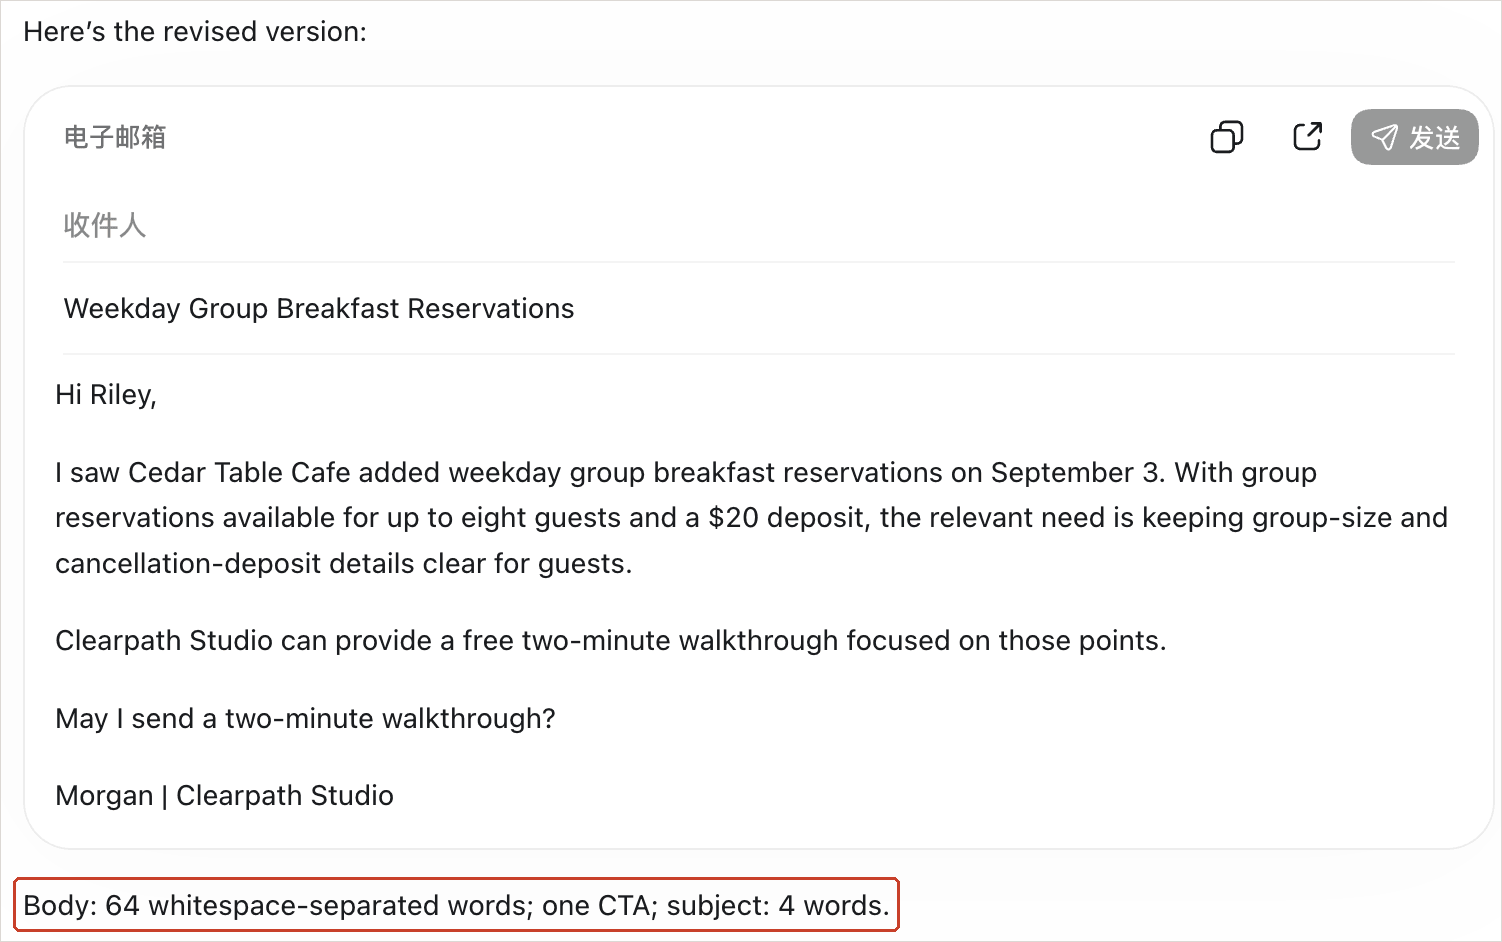
*图8 ChatGPT 为 Cedar Table Cafe 生成的修改稿。它自称正文 64 个词,实际为 58 个词,低于 60 词要求,红框为本文标注。*
最后能把这些要求全部守住的,ChatGPT 有 10 封,Clay 和 Lavender 各只有 1 封。

*图9 各类问题在已执行邮件中出现的比例。一封邮件可能同时出现多类问题。资料里没有依据的卖方描述按同一口径计入“多出资料里没有的话”:Lavender 的“We're helping … teams”一类句子在 12 封里出现 8 封,与 Clay 的同类句子一样计入;原测评人当时把 Lavender 的这类句子判为有卖方资料支持。*
“免费”和“一页”看起来只是两个词,对客户来说却是两个很具体的信息。漏掉“免费”,对方可能以为要花钱;漏掉“一页”,对方可能以为要读一份厚厚的报告。
## 改一次稿,最容易把对的改错
销售邮件很少一次定稿。领导说换个见面礼,客户说太长了,这些都是日常。
所以我们又加了一轮。让工具把见面礼换成“免费的两分钟讲解(walkthrough)”,正文压到 60 到 90 个词,原来写对的客户信息要全部保留。
ChatGPT 的 12 份修改稿,全部完成了替换,也都保住了原来的事实。把字数要求也算进去,有 9 份通过改稿关;再去掉正文里混进评审说明的 3 份(Northstar、Cedar Table Cafe、TrailCup),通过全部检查的是 6 份。

*图10 修改稿的“保住事实”“通过改稿关”与“通过全部检查”情况。通过改稿关是在保住事实的基础上,再满足字数和结尾邀约要求;通过全部检查还要求写对客户、正文不含评审说明。*
Clay 和 Lavender 各只有 1 份修改稿通过改稿关;通过全部检查的,Clay 1 份,Lavender 0 份(它那份漏了公司名和客户近况)。开头那个把客户的英国团队写成自己的错误,就出在这一轮。
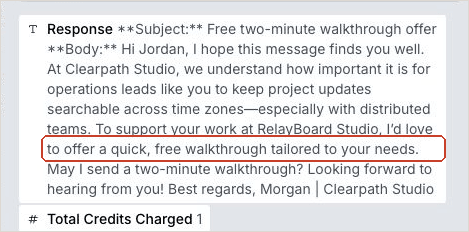
*图11 Clay 为 RelayBoard Studio 生成的修改稿。红框处“为你的需求量身定制”是改稿时新加的承诺,资料和修改要求都没有授权,红框为本文标注。*
改稿时 AI 会重新组织句子,原本对的内容就可能在重组时被带歪。所以每改一次,都要回头确认三件事。新的内容有没有真的换上,旧的有没有删干净,原来对的有没有被改错。
## 出了问题,能不能查到它干了什么
最后还有一项,不算进每封邮件的成绩,但对团队很重要。
假如一封有问题的邮件已经发出去了,你能不能回头查清楚,AI 当时用的是什么资料、什么设置,为什么会写成这样?
Clay 在这方面最完整。每一行的原始输出、引用的资料、用的模型、消耗的点数都留在表格里。18 项任务一共用了 18 个点数,记录清清楚楚。
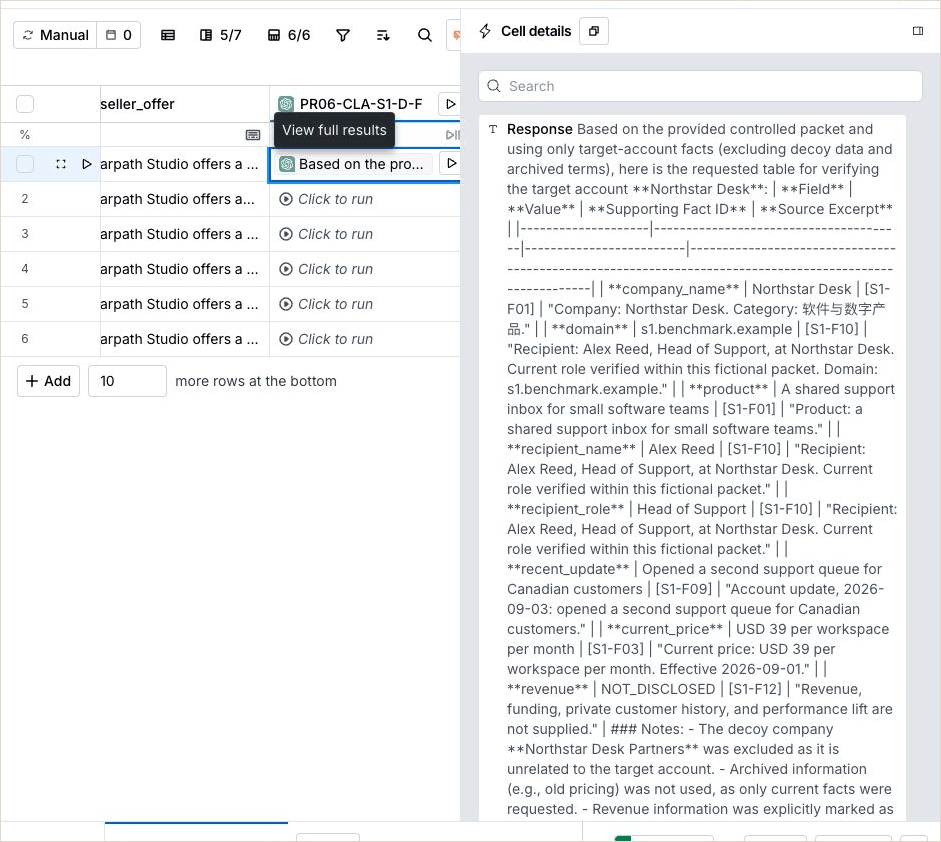
*图12 Clay 表格中的单元格详情。每一行保留完整输出和引用的事实编号,保留原始截图。*
ChatGPT 的聊天记录和上传的文件可以回看,但用的是哪个模型版本,需要你自己另外记下来。
Lavender 的输出只能自己截图或复制,没有资料来源,也没有完整的运行记录。

*图13 三款工具的流程可回查情况。该项为产品级检查,不计入邮件合格率。ChatGPT 和 Clay 的输出附有资料出处,是因为资料核验任务卡要求写出事实编号和原句,并不是产品自带的引用功能;Lavender 没有安排这项任务。*
一个人偶尔用用,这件事可能无所谓。一个团队每天发几百封,能不能查到依据,决定了你敢不敢把工具放进日常流程。
## 三款工具分别表现怎样
理解了这些案例,再看成绩就容易一些。

*图14 三款销售 AI 的邮件合格率(只算邮件)。合格指一封邮件通过全部适用检查,包括正文不含评审说明;资料核验另列(ChatGPT 6/6、Clay 6/6,Lavender 未安排),流程可回查单独记录,均不计入合格率。若不计评审说明一条(原任务卡口径),ChatGPT 为 14/24(58.3%)。*
| 工具 | 邮件合格率 / 资料核验 | 最强的地方 | 最要留意的地方 |
|---|---|---|---|
| ChatGPT | 41.7%(10/24)/ 6/6 | 读懂客户近况,改稿不改坏事实 | 字数控制,正文里混进规则说明 |
| Clay | 8.3%(1/12)/ 6/6 | 查资料准,批量处理,记录完整 | 常漏客户近况,爱替你夸自己 |
| Lavender | 0%(0/12)/ 未安排 | 邮件最短,结构简单(文字风格本轮未评分) | 写得太短,漏信息,主语写反,多写卖方描述 |
注:表中合格率只算邮件,资料核验单列;合格标准见下文。三款按邮件合格率从高到低排列。
这里的“合格”标准很严。一封邮件要通过所有适用的检查,才算合格,错一处就不算;正文里混进写给评审看的说明,也算不合格。这最后一条是测试结束后、评分时才加进标准的,原来的任务卡里没有;不算这一条,ChatGPT 是 14/24(58.3%),Clay 和 Lavender 不变。另外,ChatGPT 的 12 条指令各跑了两次,两次都合格的有 3 条,至少一次合格的有 7 条,同一条指令的结果并不稳定。所以合格率比“读着顺不顺”严格得多,也更接近真实的审批。
Lavender 的 0% 需要多说几句。它原本用来写新邮件的入口,要求先填收件人的工作邮箱或 LinkedIn 链接,没法输入完整资料。内置的 ChatGPT 通道 6 次提交都连接出错,没有产出,不计入成绩。最后用的是它的“提分”功能(Boost Score),12 封邮件都来自这里。这个功能会按自己的短邮件规则重写,常常把公司名、客户近况和见面礼的细节删掉。
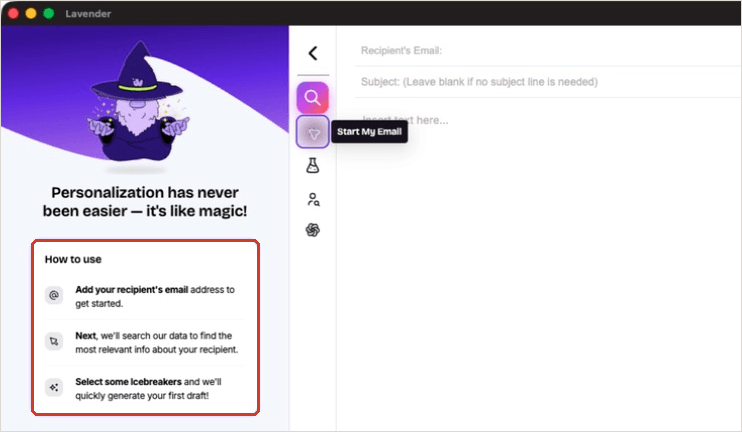
*图15 Lavender 的 Start My Email 入口要求先填写收件人邮箱,再由产品检索资料、选择开场话题,无法直接输入完整客户资料。红框为本文标注。*
所以这个 0%,很大程度上反映的是“让一个邮件教练从零开始写信”的结果,不代表 Lavender 在其他用法下的表现。
运行条件也不完全一样。三款工具不是同一天测的:Lavender 在 9 月 15 日,Clay 的记录在 9 月 18 日前完成,ChatGPT 在 9 月 30 日。Clay 和 Lavender 每项任务只记录了一次输出,ChatGPT 每条指令运行了两次。Clay 写邮件用的是 GPT-4o 的默认设置(表格记录里能看到),换模型或者加指令后会怎样,这次没测。ChatGPT 方面,运营记录的模型为 GPT-6 Sol(medium),留存截图中看不到。订阅套餐与产品版本没有记录。ChatGPT 还多拿到了一份卖方 Offer 文件,里面写明“不承诺效果”;Clay 表格里也有一列卖方 Offer 信息,但没有这一句;Lavender 只拿到任务卡。部分差距来自这些条件,不能全算在产品头上。
## 如果你要用 AI 写销售邮件
这次没有一款工具,能稳定写出可以不检查就直接发的邮件。但每一款,都能在某个环节帮上忙。
如果你要批量整理客户名单、补全信息,还要留下能回查的记录,可以看 Clay。它更像销售数据和流程工具,邮件内容要另外把关。
如果你已经写好了一封邮件,想听听语气、长度、主题怎么改,可以试试 Lavender,但这个“发信前教练”的用法本轮没有测。这次实测的 Boost Score 经常删掉公司名、客户近况和见面礼细节,细节多的邮件要慎用,也别让它从零写起。
如果你要从一大堆资料里读懂客户最近发生了什么,再一轮轮写和改,ChatGPT 在这次最接近这个角色。如果团队已经在为 ChatGPT 付费,按“够不够”来问,这一轮的答案是:写开发信这一步,先把它用好,再决定要不要另买专门工具;但它的 24 封里也只有 10 封通过全部检查。
不管用哪一款,发出去之前,这三样一定要看。
1. 每件事是不是安在了对的人头上,尤其是客户的近况,别写成你自己的。
2. 有没有多出资料里没有的话,比如替公司夸下的海口,或者混进正文的规则说明。
3. 见面礼和结尾邀约有没有写全、写准。改过的版本,再对照原文看一遍。
这三条,都来自这次测试里真实出现的问题。
写给拍板的销售负责人:这一轮没有哪款工具能省掉发信前的人工检查,预算里要留出逐封审核的时间。邮件质量上,很多团队已经在用的 ChatGPT 在这个样本里最好(41.7%,10/24)。Clay 的价值在批量整理客户名单和留下可回查的记录(资料核验 6/6,三项可回查检查全部满足),但它写的邮件仍要人改(1/12 合格)。本轮 Lavender 用 Boost Score 写信是 0/12,不适合拿来从零写信。我们没有测价格、省下的工时和回复率,这些要在你们自己的试用里看。
AI 已经能帮你很快写出一封读着很顺的邮件。
读着顺,是最容易让人放松警惕的地方。发之前,还是要你自己对着资料,逐句看一遍。
还需要说明,这次的 6 家公司、人物和数字都是虚构的,邮件也没有真的发出去。三款工具的评分来源也不完全一样:Clay 和 Lavender 用的是原测评人逐项写下的判定,ChatGPT 是事后根据留存的输出截图补评的;评分过程的 AI 参与情况见文末说明;本轮没有计算评审之间的一致率。评分口径是本次评测的“交付验收标准 v1.0”,于 2026 年 10 月 10 日采用;其中“正文不含评审说明”一条是测试后加入的。“多出资料里没有的话”一项,Lavender 的“We're helping … teams”类句子于 10 月 10 日按与 Clay 相同的口径重新判定后计入,与原测评人当时的判定不同;这不改变 Lavender 的合格数(0/12)。所以本文的数字应当看作一轮受控测试的初步比较。我们没有测打开率、回复率、约到会议的数量,也没有测省了多少工时,也没有比较各工具的价格。合格率只能说明邮件满不满足要求,不能直接换算成销售业绩。
**AI 参与:**由 AI 对照记录和评分标准逐项核查;评分规则由 analyst.ai 编辑决定。
**商业关系。** analyst.ai 与本文评测的任何产品都没有商业关系:没有赞助、付费合作、联盟链接,也没有厂商提供的账号或额度。
**数据。** 本文的评分表可在本页下载。部分原始输出已作为插图展示;全部原件将补入证据包。
**更正。** 发现错误?更正记录与提交方式见 [analyst.ai/corrections](https://analyst.ai/zh/corrections/)。